Zyphra выпустила Zamba2-VL: визуальные модели с откликом в 10 раз быстрее
Zyphra выпустила семейство открытых мультимодальных моделей Zamba2-VL — три варианта: 1.2B, 2.7B и 7B параметров, лицензия Apache 2.0. Архитектура гибридная: блоки Mamba2 чередуются с Transformer-слоями. Главный выигрыш — время до первого токена сокращается примерно в 10 раз при сопоставимом качестве с чистыми Transformer VLM.
AI-обработка оригинала MarkTechPost; редакция Hamidun News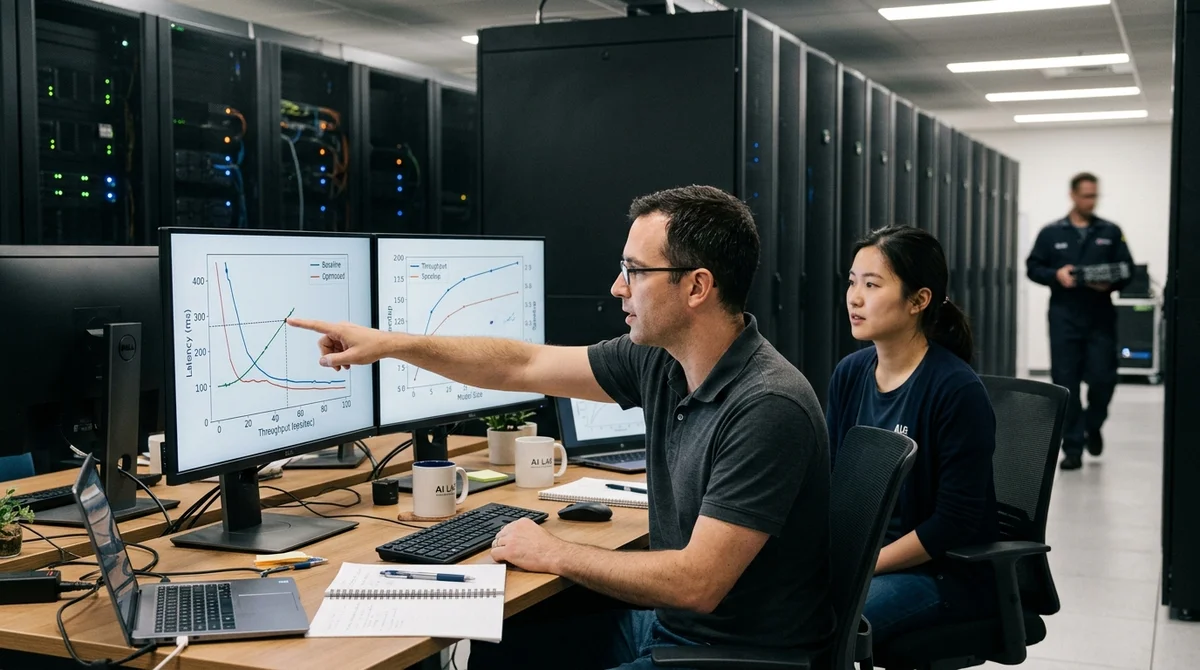
Компания Zyphra выпустила открытое семейство визуально-языковых моделей Zamba2-VL на 1.2B, 2.7B и 7B параметров. В основе — гибридная архитектура, объединяющая блоки Mamba2 и Transformer. Ключевой результат: время до первого токена сокращается примерно в 10 раз по сравнению с чистыми Transformer VLM сопоставимого размера.
Три размера, одна лицензия Семейство включает три варианта: 1.2B, 2.7B и 7B параметров.
Все три выпущены под лицензией Apache 2.0, что означает свободное коммерческое использование без ограничений на встраивание, доработку и перераспределение — полная свобода для коммерческих и исследовательских проектов. Zamba2-VL — полноценные визуально-языковые модели.
Они совместно обрабатывают изображения и текст, что открывает применение в широком спектре задач: описание картинок и фотографий, визуальный вопросно-ответный режим, анализ документов с иллюстрациями, разбор скриншотов пользовательских интерфейсов, работа с медицинскими снимками. В отличие от чистых текстовых LLM, VLM способны отвечать на вопросы о том, что изображено на картинке, и совмещать визуальный и текстовый контекст в одном запросе. По качеству на стандартных бенчмарках Zamba2-VL удерживает позиции вровень с чистыми Transformer VLM аналогичного размера.
Переход на гибридную архитектуру не требует жертвовать точностью ради скорости — оба показателя сохраняются на конкурентном уровне.
Как устроен гибридный бэкбон
Большинство современных языковых и мультимодальных моделей строится на чистой Transformer-архитектуре. В ней каждый новый генерируемый токен «просматривает» всю предыдущую последовательность через механизм внимания (attention). Это мощный подход, но вычислительно дорогой: при длинных контекстах объём работы растёт квадратично.
Именно здесь появляется узкое место по скорости — в том числе высокое время до первого токена. Mamba2 — архитектура на базе пространства состояний (state space model, SSM). Вместо полного перебора истории она сжимает предшествующий контекст в компактное «состояние», которое обновляется линейно по мере обработки новых токенов.
Zamba2-VL чередует блоки Mamba2 с обычными Transformer-слоями: SSM-блоки обеспечивают скорость и эффективность, Transformer-слои добавляют гибкость при работе со сложными зависимостями. Результат: Время до первого токена сокращается примерно в 10 раз Качество остаётся конкурентным с чистыми Transformer VLM Меньший вычислительный след при инференсе Лучшее масштабирование на длинных контекстах * Возможность деплоя на менее мощном железе без потери отзывчивости ## Почему TTFT решает Время до первого токена (time-to-first-token, TTFT) — промежуток между отправкой запроса и появлением первого символа ответа. Именно он определяет ощущение «живости» в интерактивных системах: чат-ботах, голосовых ассистентах, API-сервисах, где важна скорость реакции.
Пока модель думает — пользователь ждёт. Высокий TTFT ощущается как «зависание», даже если итоговый ответ качественный. Снижение TTFT в 10 раз — кратный практический выигрыш.
При тех же аппаратных ресурсах это означает либо значительно более отзывчивый сервис, либо возможность обслуживать существенно больше запросов одновременно. Для компаний, платящих за GPU-время, оба варианта напрямую влияют на юнит-экономику продукта.
Открытые модели с такой скоростью отклика позволяют строить продукты
там, где задержка ответа раньше делала целый класс решений нежизнеспособным.
Что это значит
Гибридные архитектуры SSM + Transformer продолжают двигаться из академических статей в практические продукты. Выпуск Zamba2-VL семейством из трёх моделей — от компактной 1.2B до полноразмерной 7B — покрывает разные сценарии деплоя: от устройств с ограниченными ресурсами до серверных ферм. Открытость под Apache 2.0 снижает порог входа: команды могут взять готовую быструю мультимодальную модель без зависимости от коммерческих API — со всеми их ценами, лимитами и риском внезапного изменения условий.
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.