NVIDIA оптимизировала BEV-пулинг на GPU для беспилотников, роботов и пространственного ИИ
NVIDIA рассказала, как ускорить BEV-пулинг на GPU — ключевую операцию в системах восприятия для беспилотников и роботов. BEV-модели объединяют изображения с нескольких камер в единую карту сверху, помогая ИИ видеть полосы, машины и пешеходов. NVIDIA предлагает оптимизированные CUDA-ядра, TensorRT-плагин и предвычисление индексов — чтобы perception работал в реальном времени даже на встраиваемых чипах Jetson.
AI-обработка оригинала NVIDIA Developer Blog; редакция Hamidun News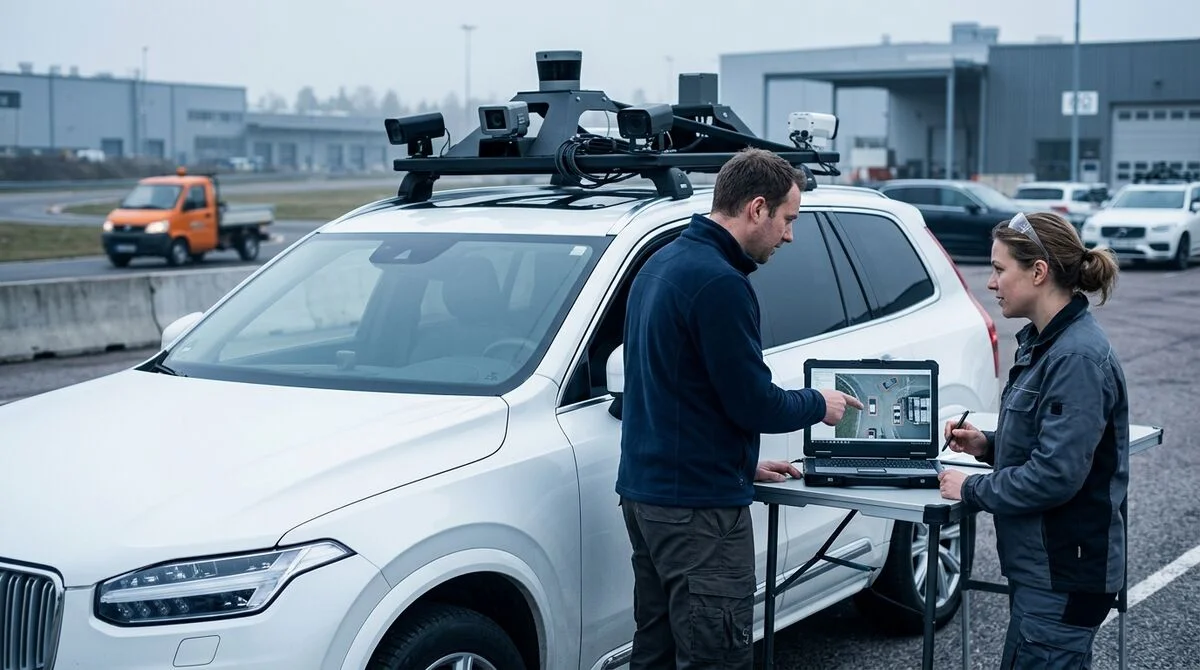
NVIDIA опубликовала детальное техническое руководство по ускорению BEV-пулинга на своих GPU — операции, которая становится обязательной для любой системы с несколькими камерами: от беспилотных автомобилей до промышленных роботов и пространственных ИИ-систем.
Что такое BEV-восприятие BEV расшифровывается как Bird's-Eye-View — вид сверху.
Вместо того чтобы обрабатывать изображения с шести-восьми камер по отдельности, модель проецирует признаки каждой из них в единую топ-даун-карту. На этой карте ИИ рассуждает о пространстве так же, как человек смотрит на план дороги: видит полосы, автомобили, пешеходов и свободное место в едином координатном пространстве. До появления BEV большинство систем использовали независимые детекторы для каждой камеры и отдельный модуль слияния данных. Это порождало несогласованность на стыках обзора и усложняло оценку расстояний. BEV решает проблему принципиально — проекция в единое пространство устраняет стыки между камерами и упрощает последующее планирование маршрута. BEV-модели стали де-факто стандартом в автопилотах и робототехнике. В промышленной робототехнике такой подход позволяет навигационному стеку получить целостную картину окружающей среды без сложного слияния данных между несколькими независимыми классификаторами.
Где возникает узкое место
Ключевая операция в BEV-пайплайне — сам пулинг: каждую точку топ-даун-карты нужно «опросить» по каждой из камер, получить соответствующий признак из фичи-карты и усреднить результаты. При разрешении BEV-карты 200×200 ячеек и шести камерах это десятки миллионов операций с хаотичным паттерном доступа к памяти.
- Нелинейный доступ к памяти несовместим с кешем GPU — каждое обращение может оказаться промахом Пропускная способность памяти становится настоящим узким местом, а не вычислительная мощность ядер BEV-пулинг занимает до 30–40% времени всего inference-цикла При обновлении карты с частотой 20 Гц задержки накапливаются критически быстро Наивная CUDA-реализация работает плохо даже на мощных дата-центровых GPU и чипах Orin NVIDIA детально разбирает, почему проблема не решается простым увеличением мощности GPU — оптимизировать нужно именно паттерн работы с памятью и порядок вычислений.
Что предлагает NVIDIA
Основное решение — оптимизированные CUDA-ядра с тщательно спроектированным порядком операций и активным использованием разделяемой памяти (shared memory). Ключевая идея — группировать запросы так, чтобы несколько потоков обращались к соседним адресам одновременно. Это превращает хаотичные одиночные обращения в эффективные групповые транзакции, которые GPU обрабатывает значительно быстрее.
NVIDIA также предоставляет готовый плагин для TensorRT: он встраивается в любой inference-пайплайн без переписывания модели. Для команд, которые уже используют TensorRT в производстве, это особенно ценно — оптимизация применяется без изменения архитектуры сети. Отдельно описана техника предвычисления индексов проекции: соответствия между BEV-ячейками и пикселями камер вычисляются один раз при инициализации и хранятся в памяти.
На чипах Jetson Xavier и Orin — которые стоят в реальных роботах и беспилотниках — это даёт заметный прирост именно из-за ограниченной вычислительной мощности по сравнению с дата-центровыми GPU.
«Правильная реализация BEV-пулинга — это разница между системой,
работающей в реальном времени, и системой, которая не успевает», — следует из технического материала NVIDIA.
Что это значит BEV-восприятие превращается из исследовательской концепции в базовый компонент
Physical AI — термина, которым NVIDIA всё активнее описывает роботов, беспилотники и промышленную автоматику. Оптимизация таких базовых операций, как BEV-пулинг, напрямую определяет, сколько камер можно задействовать и с какой частотой обновлять карту восприятия. Для команд, работающих на платформе NVIDIA Jetson или использующих TensorRT, это руководство даёт конкретные инструменты ускорения без необходимости менять архитектуру модели.
- 28 окт. 2026 г.Liquid AI выпустила LFM2.5-24B-A2B: агент с 2B активных параметров
- 28 окт. 2026 г.PyTorch 2.15 ускорил MoE-модели на Mac в 5–6,5 раза и принёс FP8
- 28 окт. 2026 г.Anthropic подала S-1 на IPO с оценкой $2 трлн: маржа 85%, Q2 в плюсе
- 28 окт. 2026 г.NVIDIA Kumo Relational обходит supervised ML на 41 задаче без обучения
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.