Docling Parse: пайплайн разбора PDF с точностью до символа и координаты
Docling Parse разбирает PDF не как поток текста, а как двумерный документ: каждое слово и символ получают координаты на странице. Туториал показывает, как построить такой пайплайн — с генерацией тестового PDF, низкоуровневым парсингом, визуальными оверлеями и выгрузкой в JSON и CSV, готовыми для RAG-систем и анализа порядка чтения.
AI-обработка оригинала MarkTechPost; редакция Hamidun News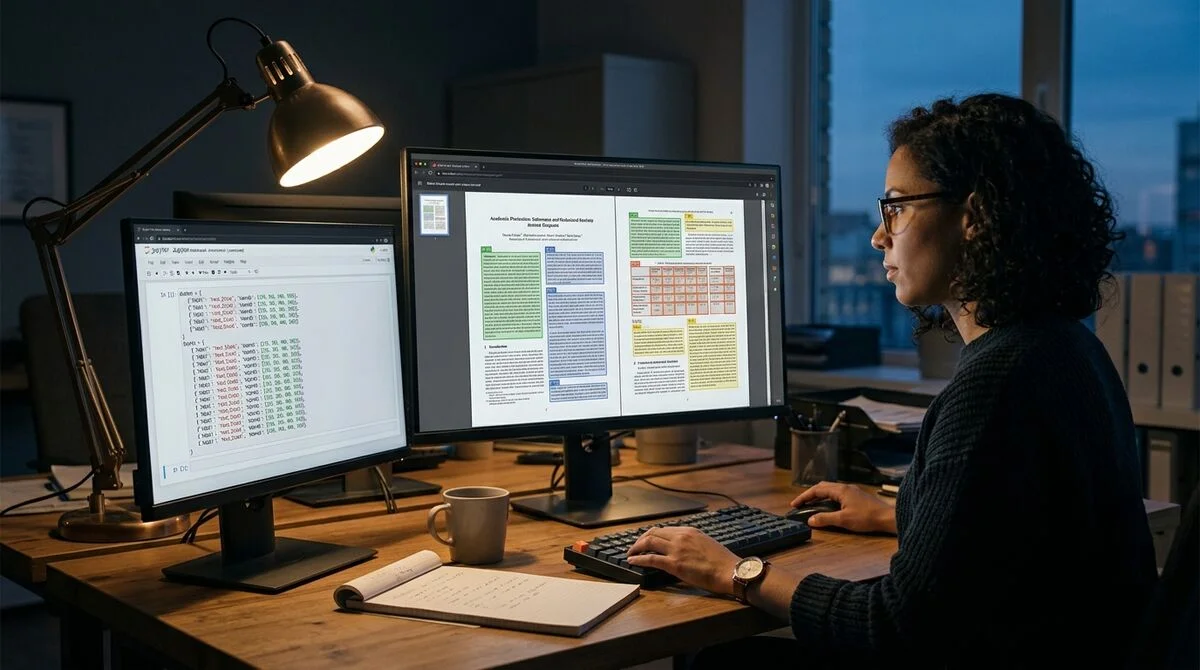
Docling Parse — низкоуровневая библиотека для структурного анализа PDF-документов. Туториал показывает, как построить полноценный пайплайн разбора документов с точностью до символа и страничной координаты — и получить данные, готовые для RAG-систем и задач извлечения знаний.
Зачем нужен структурный парсинг
Стандартные PDF-парсеры работают поверхностно: извлекают текст одним линейным потоком, теряя позиции элементов, порядок колонок и структуру таблиц. Для простого поиска слов или копирования это приемлемо. Но для RAG-систем и document intelligence важно знать, где именно на странице находится каждый элемент — что стоит слева, что справа, что является заголовком, а что подписью к таблице. Docling Parse подходит к задаче иначе. Библиотека анализирует PDF не как поток символов, а как двумерный документ с явными пространственными отношениями. Каждое слово, символ и строка получают координаты bounding box, привязанные к конкретной странице. Благодаря этому можно восстановить правильный порядок чтения даже в документах с нестандартной вёрсткой: многоколоночным текстом, боковыми сносками, таблицами с объединёнными ячейками и наложенными векторными элементами.
Как устроен пайплайн Туториал строит рабочий процесс с нуля.
Первый шаг — подготовка Python-окружения: авторы подробно останавливаются на типичных конфликтах зависимостей в Google Colab и показывают, как настроить среду так, чтобы пакеты не конфликтовали между собой. Для тестирования генерируется специальный многостраничный PDF: с текстом в несколько колонок, блоками, имитирующими таблицы, векторными фигурами и встроенным растровым изображением. Документ намеренно выбран сложным — простой однострочный файл не позволил бы показать возможности низкоуровневого парсера в реальных условиях.
Docling Parse разбирает файл и возвращает: слова с координатами bounding box на каждой странице отдельные символы с точными позициями строки и их пространственные отношения друг к другу структурные данные для восстановления правильного порядка чтения Поверх результатов рендерятся визуальные оверлеи — цветные прямоугольники вокруг каждого обнаруженного элемента. Это позволяет буквально увидеть, что именно парсер считал из документа, и значительно упрощает отладку: сразу становится видно, где граница между блоками определена неверно или где несколько символов слились в один нераспознанный элемент.
Что получается на выходе Финальные данные сохраняются в двух форматах.
JSON хранит полную иерархическую структуру документа: страницы → блоки → строки → слова → символы, каждый с координатами и метаданными. CSV даёт плоское представление всех элементов — удобно для быстрого анализа в pandas или Excel. Оба формата пригодны для следующего шага в пайплайне: передачи данных в RAG-систему, обучения классификатора документов или семантического поиска с учётом пространственного контекста. Например, можно задать запрос «все строки из правой колонки» или «текст, стоящий непосредственно под заголовком» — что при обычном плоском извлечении текста в принципе недостижимо.
Что это значит
Низкоуровневый парсинг PDF — необходимый, но часто пропускаемый слой document intelligence. Большинство команд начинают с готовых инструментов, которые прячут структуру документа за удобным API. Docling Parse открывает этот уровень напрямую: без внешних API, полностью локально, с воспроизводимым кодом. Для компаний, строящих корпоративные RAG-системы или продукты для обработки документов, это базовый кирпичик архитектуры — тот слой, без которого качество извлечения информации трудно улучшить.
- 29 окт. 2026 г.Anthropic в S-1 показала: 11 900 клиентов платят от $100 тысяч в год
- 29 окт. 2026 г.Google DeepMind нашла дефект softmax: градиент обнуляется при отрыве 16,6
- 28 окт. 2026 г.CNN 2015 года обошла GPT-6 Astra и Claude Fable 5.1 в диагностике рака кожи
- 28 окт. 2026 г.Google научила LLM «спать»: SLEEP закрепляет знания в весах, до 10 млн токенов
Соберите рабочего ИИ-агента или сервис своими руками без ручного кода
В Академии Жемала Хамидуна (academy.hamidun.com) открыт бесплатный 72-часовой тест-драйв: интерактивные скетч-уроки по Claude Code и Cursor, живой Tech Radar и готовые шаблоны агентов.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.