AWS и NVIDIA запустили масштабное обучение робота Unitree H1 на SageMaker AI
AWS и NVIDIA показали, как масштабировать обучение с подкреплением для гуманоидного робота Unitree H1 в облаке. Симулятор NVIDIA Isaac Lab теперь работает поверх Amazon SageMaker AI: тысячи параллельных виртуальных сред, два режима запуска — HyperPod для долгих экспериментов и Training Jobs для разовых. На одном H100-узле можно тренировать 4096 сред одновременно, а время обучения сокращается с дней до часов.
AI-обработка оригинала AWS Machine Learning Blog; редакция Hamidun News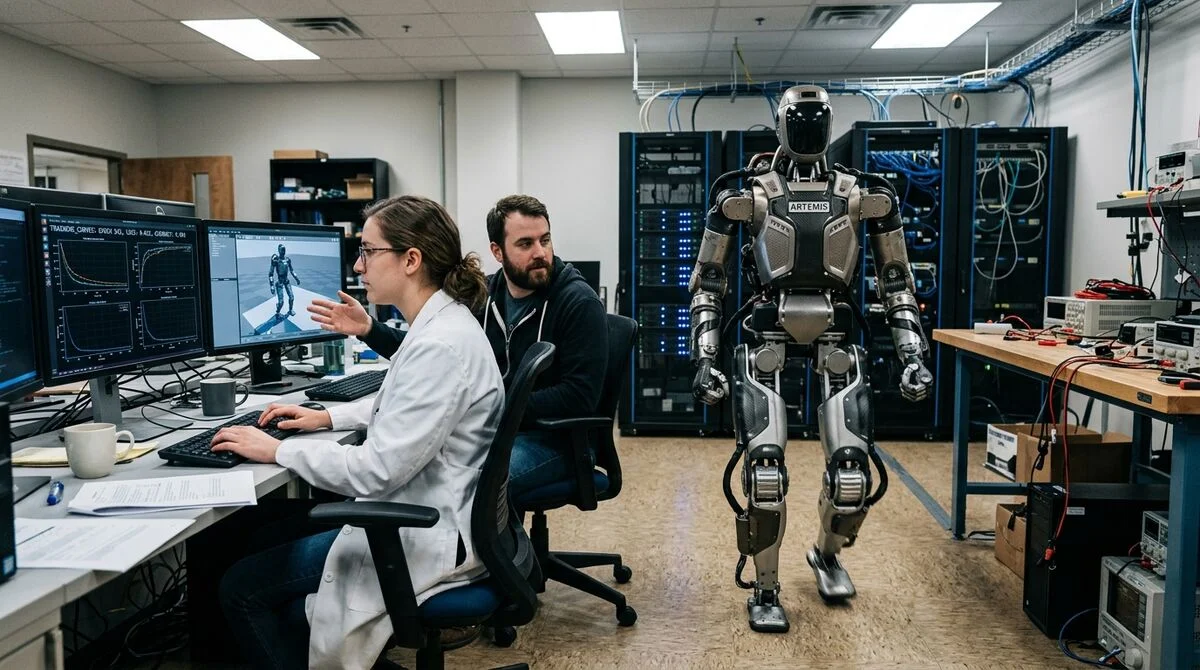
AWS совместно с NVIDIA показала полный пайплайн для обучения политик управления гуманоидным роботом Unitree H1 прямо в облаке — без собственного GPU-кластера.
Зачем облако для роботов
Reinforcement learning для физических роботов требует миллиардов шагов симуляции — это не преувеличение. Чтобы гуманоид научился идти вперёд без падений, нейросеть должна пройти через десятки миллиардов взаимодействий виртуального агента со средой. Делать это в реальном мире дорого и опасно: один неудачный эксперимент — потенциальный ремонт за тысячи долларов, а сам процесс занял бы годы вместо часов.
Именно поэтому отрасль делает ставку на физическую симуляцию. Гонка за «законом Мура для роботов» уже началась: Tesla, Figure, Boston Dynamics и десятки стартапов вкладывают сотни миллионов в создание синтетических сред для обучения. NVIDIA Isaac Lab — GPU-ускоренный симулятор, способный одновременно запускать тысячи копий виртуальной среды на одном узле.
Прежде его использовали преимущественно в крупных корпоративных и университетских лабораториях с дорогостоящим железом. Теперь Isaac Lab напрямую интегрирован с Amazon SageMaker AI. Это означает, что запрос на сотни GPU выполняется за минуты, а инженеру не нужно думать об инфраструктуре — только о коде политики и конфигурации задачи.
Два варианта запуска AWS предлагает два режима для разных сценариев использования: * **SageMaker
HyperPod — постоянный управляемый кластер; инфраструктура сохраняется между запусками, что удобно для многонедельных исследований и итеративного подбора гиперпараметров SageMaker Training Jobs — одноразовый managed-запуск; ресурсы выделяются строго под задачу и автоматически освобождаются по её завершении, что упрощает контроль бюджета Поддерживаются инстансы серии p4d и p5 с NVIDIA A100 и H100 соответственно Isaac Lab разворачивается в стандартном Docker-контейнере; веса модели и чекпоинты автоматически сохраняются в Amazon S3 Метрики обучения — reward, episode length, entropy loss — поступают в Amazon CloudWatch в реальном времени Ключевое преимущество обоих вариантов — снятие операционной нагрузки. Не нужно самостоятельно настраивать Kubernetes, управлять InfiniBand-сетью между узлами или вручную балансировать нагрузку между GPU.
Как проходит обучение
Unitree H1 Unitree H1 — один из наиболее доступных серийных гуманоидов: рост около 180 см, вес 47 кг, 19 степеней свободы. Это делает его популярной платформой для академических исследований в области управления движением. В симуляции Isaac Lab тысячи виртуальных копий этого робота параллельно учатся ходить через алгоритм Proximal Policy Optimization (PPO): падают, встают, корректируют баланс, получают вознаграждение за стабильное движение вперёд. Насколько точно функция вознаграждения описывает желаемое поведение — настолько качественной окажется обученная политика. На одном H100-узле Isaac Lab способен запускать до 4096 параллельных симуляций одновременно. При масштабировании на несколько узлов задействуется распределённое обучение через PyTorch DDP — синхронизация градиентов между GPU происходит автоматически.
«Масштабирование до сотен GPU через SageMaker сокращает время обучения с нескольких дней до нескольких часов», — отмечают авторы публикации в блоге AWS.
По завершении обученная политика экспортируется в форматы ONNX или TorchScript и может быть перенесена на реальное железо через NVIDIA Isaac ROS.
Что это значит
Облачный reinforcement learning для роботов выходит за рамки лабораторий с многомиллионными бюджетами на оборудование. Любая небольшая команда с AWS-аккаунтом теперь может запустить серьёзный эксперимент по обучению гуманоида без капитальных вложений в инфраструктуру. Это меняет экономику робототехники: порог входа снижается, скорость итераций растёт — и следующие прорывы в управлении физическими роботами вполне могут прийти от неожиданно небольших команд.
- 29 окт. 2026 г.Anthropic в S-1 показала: 11 900 клиентов платят от $100 тысяч в год
- 28 окт. 2026 г.Keystone убрал имя модели из кода: open-source LLM-шлюз добавляет 0,64 мс
- 28 окт. 2026 г.Wired за сутки протестировал 6 ИИ-агентов: Dots лидирует, Gemini Spark провалил обед
- 28 окт. 2026 г.Bayer запустила мультиагентный движок на AgentCore: 80% вопросов без инженеров
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.