ИИ для оценки интерфейсов: метод FlowEval от Apple
Apple ML Research представила FlowEval — фреймворк для автоматической оценки интерфейсов, генерируемых LLM и AI-агентами. Вместо медленной экспертной проверки или непрозрачных автосудей FlowEval сравнивает навигационные траектории реальных сайтов с маршрутами в AI-сгенерированном UI — и показывает, насколько результат поддерживает реальные пользовательские сценарии.
AI-обработка оригинала Apple ML Research; редакция Hamidun News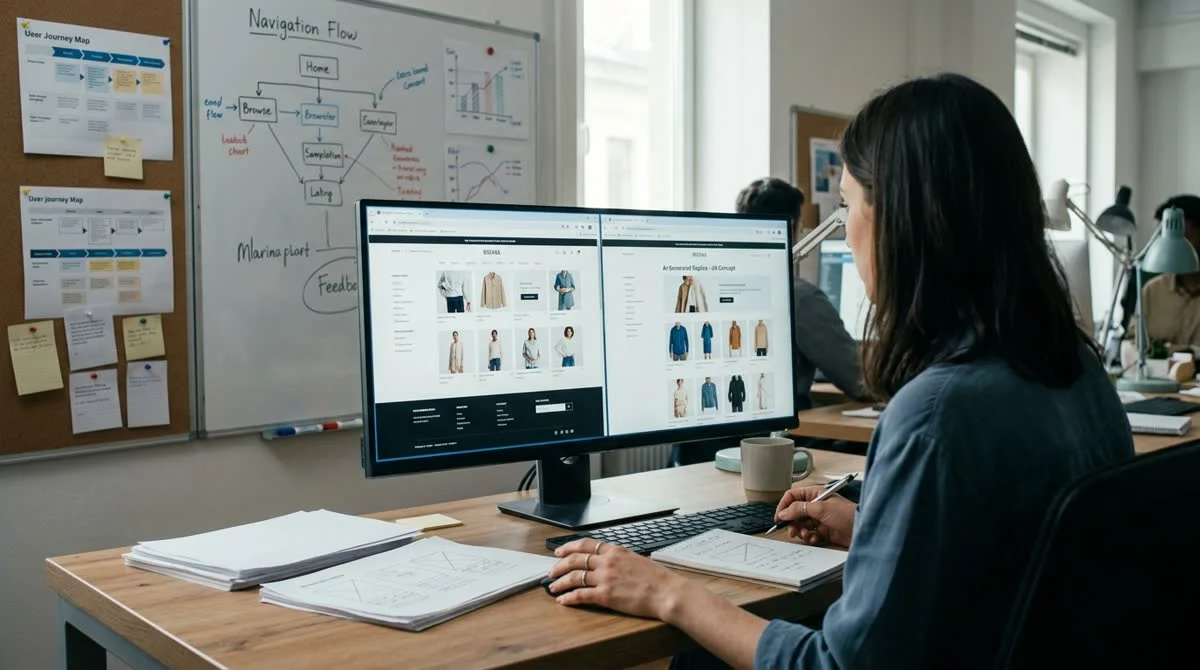
Apple ML Research представила FlowEval — ИИ-систему для проверки качества интерфейсов, сгенерированных языковыми моделями и AI-агентами, путём сравнения навигационных траекторий на реальных и AI-копиях сайтов.
Почему оценивать AI-интерфейсы так сложно?
Потому что существующие подходы оказываются между двумя крайностями, каждая из которых неудобна по-своему. Первая — привлечение экспертов: они точно тестируют критически важные пользовательские сценарии и выявляют тонкие проблемы удобства, однако этот метод медленный и дорогостоящий. Масштабировать его на сотни итерируемых UI-версий нереалистично. Вторая — автоматические оценщики: быстрые и масштабируемые, но менее точные и нередко непрозрачные — разработчику непонятно, на каком основании выставлена оценка.
FlowEval занимает позицию между этими полюсами, стремясь объединить масштабируемость автоматических методов с точностью экспертной проверки.
Как работает эталонная оценка
Ключевая идея фреймворка — эталонный подход (reference-based): за точку отсчёта берутся реальные сайты. FlowEval фиксирует навигационные траектории на оригинальных веб-страницах, а затем сопоставляет их с путями взаимодействия, которые поддерживает AI-сгенерированный интерфейс.
Что конкретно измеряет система:
- Поддержку реалистичных пользовательских потоков — не только визуальное сходство с оригиналом
- Степень близости навигационных траекторий сгенерированного UI к реальным эталонным маршрутам
- Конкретные точки отклонения: где именно AI воспроизвёл функциональную структуру некорректно
Логика проста: если навигационные потоки в сгенерированном интерфейсе близки к оригинальным — AI воспроизвёл не только внешний вид, но и функциональную структуру страницы. Там, где потоки расходятся, система указывает на конкретный компонент или шаг, вызвавший отклонение.
Такой метод даёт разработчикам объективный измеримый сигнал о качестве UI без необходимости привлекать специалистов к каждой итерации. При этом оценка воспроизводима и прозрачнее «чёрных ящиков» большинства существующих автоматических оценщиков.
Зачем это нужно индустрии?
Проблема, которую решает FlowEval, будет только обостряться. По мере того как кодирующие AI-агенты выходят в массовое производство — в IDE, standalone-сервисах и AI-пайплайнах, — разрыв между «красивым скриншотом» и «рабочим интерфейсом» становится критичным. Многие существующие бенчмарки для UI-генерации измеряют визуальное сходство или синтаксическую корректность разметки, но не отвечают на ключевой вопрос: работает ли навигация, заполняются ли формы, ведут ли кнопки туда, куда ожидает пользователь?
FlowEval переносит акцент с «выглядит похоже» на «работает как надо». Примечательно, что инструмент публикует Apple ML Research — компания, которая активно развивает on-device AI, но реже других крупных лабораторий открывает свои методы. Это говорит о том, что проблема достаточно острая, чтобы Apple решила поделиться подходом с академическим сообществом.
Что это значит
FlowEval предлагает методологический мост между дорогостоящей экспертной проверкой и непрозрачными автоматическими оценщиками. Для разработчиков и исследователей, применяющих LLM и AI-агентов при создании интерфейсов, это означает возможность системно измерять качество UI-генерации и ускорять итерации — без потери надёжности оценки.
Как ИИ проверяет качество интерфейсов?
FlowEval сравнивает навигационные маршруты на реальных сайтах с маршрутами в AI-сгенерированных копиях и определяет, насколько функционально точен результат.
Почему оценка AI-интерфейсов сложнее обычного тестирования?
Существующие подходы требуют либо привлечения дорогих экспертов для точного тестирования, либо используют автоматические проверки, которые пропускают тонкие проблемы удобства.
- 28 окт. 2026 г.Liquid AI выпустила LFM2.5-24B-A2B: агент с 2B активных параметров
- 28 окт. 2026 г.PyTorch 2.15 ускорил MoE-модели на Mac в 5–6,5 раза и принёс FP8
- 26 окт. 2026 г.SpaceXAI объединила Grok, Cursor и X в одну подписку от $8 в месяц
- 26 окт. 2026 г.Apple во вторник представит умный хаб HomeView, сообщает Гурман
Вопросы и ответы по материалу
Почему оценивать AI-интерфейсы так сложно?
Потому что существующие подходы оказываются между двумя крайностями, каждая из которых неудобна по-своему. Первая — привлечение экспертов: они точно тестируют критически важные пользовательские сценарии и выявляют тонкие проблемы удобства, однако этот метод медленный и дорогостоящий. Масштабировать его на сотни итерируемых UI-версий нереалистично. Вторая — автоматические оценщики: быстрые и масштабируемые, но менее точные и нередко непрозрачные — разработчику непонятно, на каком основании выставлена оценка. FlowEval занимает позицию между этими полюсами, стремясь объединить
Зачем это нужно индустрии?
Проблема, которую решает FlowEval, будет только обостряться. По мере того как кодирующие AI-агенты выходят в массовое производство — в IDE, standalone-сервисах и AI-пайплайнах, — разрыв между «красивым скриншотом» и «рабочим интерфейсом» становится критичным. Многие существующие бенчмарки для UI-генерации измеряют визуальное сходство или синтаксическую корректность разметки, но не отвечают на ключевой вопрос: работает ли навигация, заполняются ли формы, ведут ли кнопки туда, куда ожидает пользователь? FlowEval переносит акцент с «выглядит похоже» на «работает как надо». При
Как ИИ проверяет качество интерфейсов?
FlowEval сравнивает навигационные маршруты на реальных сайтах с маршрутами в AI-сгенерированных копиях и определяет, насколько функционально точен результат.
Почему оценка AI-интерфейсов сложнее обычного тестирования?
Существующие подходы требуют либо привлечения дорогих экспертов для точного тестирования, либо используют автоматические проверки, которые пропускают тонкие проблемы удобства.
От чтения про ИИ-агентов — к запуску своего агента за вечер
Пошаговая сборка автономных агентов и MCP-связок в Hamidun Academy (academy.hamidun.com) (72 часа бесплатно) или мгновенный запуск готовых мультишаговых агентов в облаке Nomad.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.