Amazon SageMaker и DVC: сквозная трассировка ML-моделей от данных до предсказания
AWS опубликовала руководство по сквозной трассировке ML-моделей с помощью DVC, Amazon SageMaker AI и MLflow Apps. Разбираются два паттерна: lineage на уровне датасета и на уровне отдельной записи. Оба разворачиваются в вашем AWS-аккаунте через готовые ноутбуки.
AI-обработка оригинала AWS Machine Learning Blog; редакция Hamidun News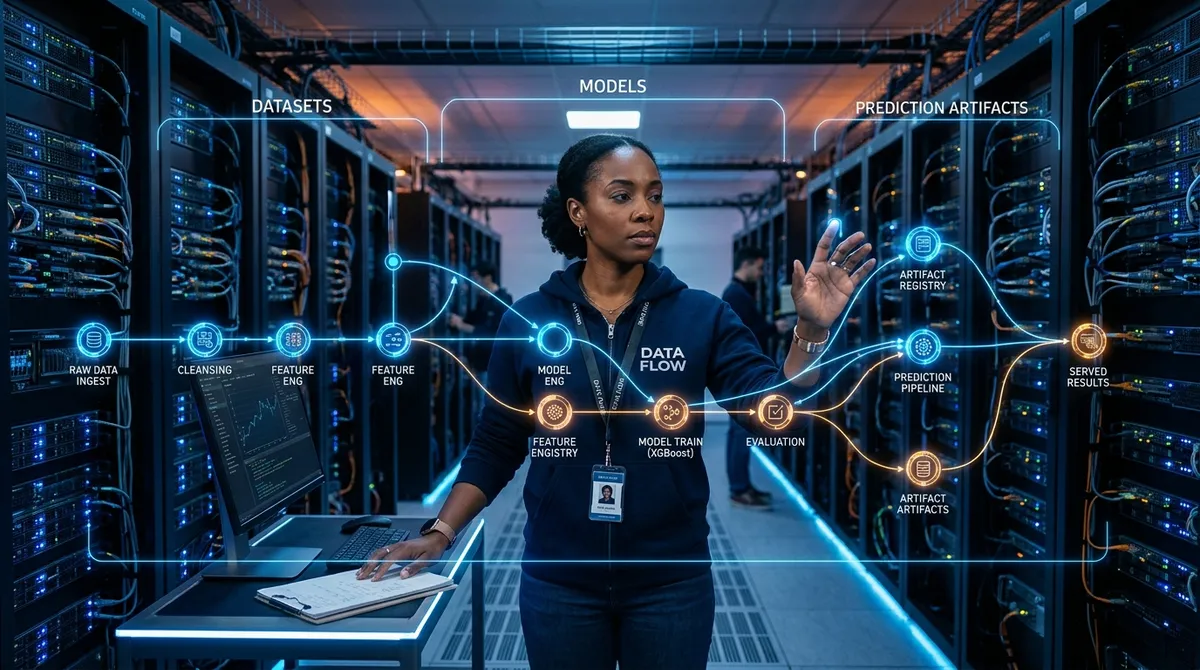
AWS Machine Learning Blog опубликовал детальное руководство по построению сквозного трекинга ML-моделей — от сырых данных до итогового предсказания — с использованием трёх инструментов: DVC, Amazon SageMaker AI и Amazon SageMaker AI MLflow Apps. Проблема, которую решает материал, хорошо знакома командам, работающим в production: непонятно, на каких именно данных обучена конкретная модель, какие трансформации к ним применялись и как отдельная запись повлияла на предсказание. Это критично при аудитах, отладке смещений (data drift) и соблюдении регуляторных требований.
DVC (Data Version Control) — open-source инструмент, который добавляет к Git версионирование больших файлов и датасетов. В связке с SageMaker он позволяет фиксировать точный снимок данных, использованных при каждом запуске обучения. SageMaker MLflow Apps, в свою очередь, хранит метрики, параметры и артефакты экспериментов — стандартный MLflow-сервер, управляемый AWS без необходимости разворачивать инфраструктуру вручную.
Авторы описывают два конкретных паттерна. Первый — dataset-level lineage: фиксируется версия датасета (через DVC-тег), параметры пайплайна обработки и ссылка на обученную модель в MLflow. Второй — record-level lineage: каждая конкретная запись из обучающей выборки привязывается к модели, что позволяет ответить на вопрос «какие именно примеры сформировали это предсказание».
Оба паттерна реализованы в виде Jupyter-ноутбуков, готовых к запуску в вашем AWS-аккаунте. Архитектура выглядит следующим образом: данные хранятся в S3 и версионируются DVC, метаданные экспериментов (параметры, метрики, артефакты) — в MLflow App, а связь между версией данных и версией модели обеспечивается через кастомные теги и артефакты DVC, зарегистрированные в MLflow. Практическая ценность подхода — в воспроизводимости.
Если через полгода выяснится, что модель ведёт себя неожиданно на определённой когорте пользователей, инженеры смогут точно восстановить, на каком датасете она обучалась, какие записи туда вошли и с какими гиперпараметрами запускалось обучение. Материал ориентирован на ML-инженеров и MLOps-команды, уже работающих в экосистеме AWS. Готовые ноутбуки существенно снижают порог входа: не нужно проектировать интеграцию с нуля — достаточно адаптировать примеры под свой датасет и пайплайн обработки.
Для компаний, которым важна аудируемость ML-систем — особенно в финансовом секторе, медицине и государственных проектах, — подобный подход становится стандартом де-факто. AWS последовательно строит инструментарий, при котором lineage перестаёт быть опциональной «хорошей практикой» и превращается в встроенное свойство пайплайна.
- 29 окт. 2026 г.Anthropic в S-1 показала: 11 900 клиентов платят от $100 тысяч в год
- 28 окт. 2026 г.Keystone убрал имя модели из кода: open-source LLM-шлюз добавляет 0,64 мс
- 28 окт. 2026 г.Wired за сутки протестировал 6 ИИ-агентов: Dots лидирует, Gemini Spark провалил обед
- 28 окт. 2026 г.Bayer запустила мультиагентный движок на AgentCore: 80% вопросов без инженеров
Внедряйте ИИ быстрее рынка вместе с инженерами и фаундерами
Внутри Vibe Club (hamidun.com/club): еженедельные живые мастермайнды и разборы архитектуры с Жемалом Хамидуном, закрытый Tech Radar, LMS и обновляемая база из 370+ боевых скиллов.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.