Российские компании переходят к системной безопасности ИИ-агентов вместо точечных проверок
ИИ-агенты уже работают с кодом, git, shell и внутренними сервисами, а значит становятся частью инфраструктуры, а не просто «умным чатом». Вместо бесконечной проверки каждого нового инструмента нужен системный подход: ограничение прав, изоляция среды, контроль сети, логов и доступа к секретам. Автор предлагает убрать слово ИИ и оценивать такие системы как обычные сервисы с очень широкими полномочиями.
AI-обработка оригинала Habr AI; редакция Hamidun News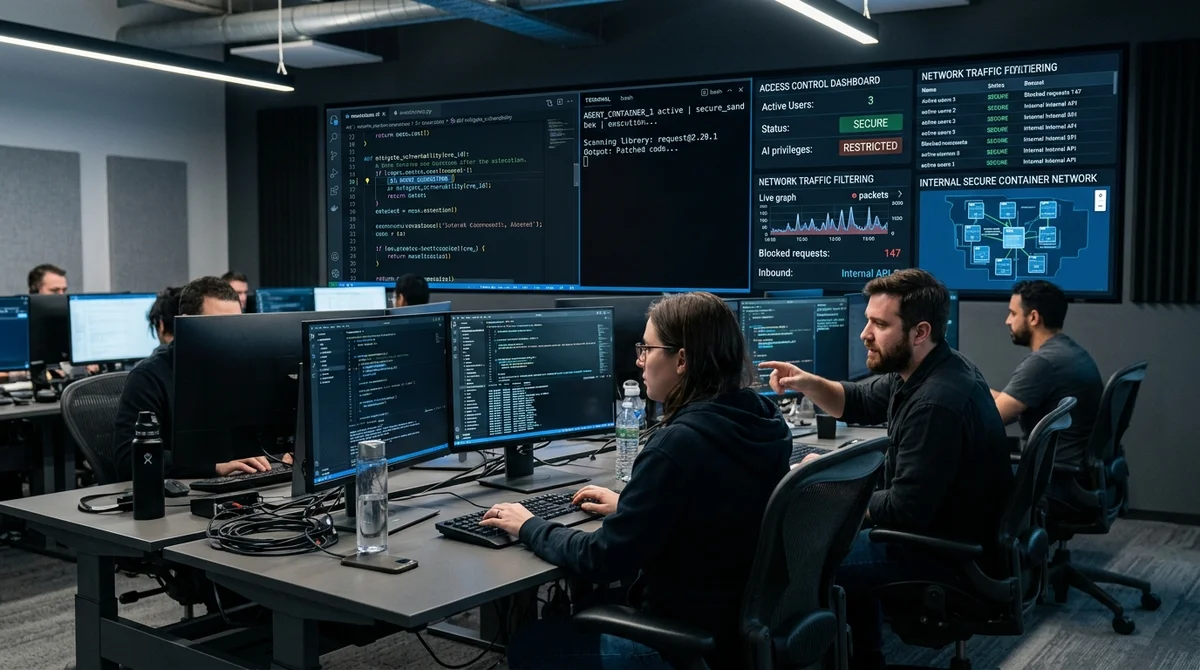
Безопасность ИИ-агентов уже нельзя решать в режиме ручного разбора каждого нового инструмента: LLM и coding-агенты получили доступ к коду, shell, git, сети и секретам, поэтому их надо рассматривать как обычные сервисы с очень широкими правами. Когда такие системы встраиваются в разработку, тестирование и эксплуатацию, вопрос стоит не в том, можно ли им доверять, а в том, какие ограничения, политики и наблюдаемость компания заложила вокруг них. За последние два-три года российские компании перестали воспринимать генеративный ИИ как любопытный эксперимент и начали встраивать его в повседневные процессы.
Речь уже не только о чатах поддержки или черновиках текстов: модели помогают разработчикам, участвуют в code review, генерируют инфраструктурный код, работают с конфигурацией и все чаще становятся частью реальных продуктов. На это же указывают и международные рекомендации: NIST предлагает смотреть на генеративный ИИ как на элемент критичной инфраструктуры, а ENISA отдельно разбирает его роль в DevSecOps и инженерной автоматизации. Логика простая: как только модель получает доступ к данным, инструментам и возможности что-то выполнять, она перестает быть просто интерфейсом и становится рабочим узлом системы.
Вместе с этим меняется и профиль угроз. К классическим проблемам вроде ошибок авторизации и инъекций добавляются риски, которые описывает OWASP Top 10 for LLM Applications: prompt injection, небезопасная обработка ответа модели, утечки секретов через контекст, слишком широкие полномочия агентов и небезопасный дизайн плагинов или tools. Исследование нескольких ИИ-агентов показало повторяющуюся картину: почти у всех есть доступ к shell через локальные команды, Docker или SSH, многие умеют напрямую работать с git, создавать ветки и коммиты, а в конфигурации нередко встречаются опасные режимы в духе bypassPermissions.
В такой связке достаточно одной удачной инъекции или одного небезопасно обработанного ответа модели, чтобы агент выполнил произвольную команду, вытащил токены и ключи, незаметно изменил код или начал ходить по внутренним сервисам и CI/CD-цепочке. Проблема в том, что ручная проверка каждого нового агента плохо масштабируется. Даже если разработчик инструмента уже добавил песочницу по умолчанию, модуль для работы с секретами, редактирование чувствительных данных в логах и документацию по безопасному запуску, службе безопасности все равно приходится почти с нуля разбирать, насколько этим настройкам можно доверять.
Поэтому автор предлагает убрать из обсуждения само слово ИИ и смотреть на агента как на black box-сервис с широкими правами. Если такой сервис умеет читать и менять файлы, запускать команды, вызывать внешние API и пушить код, то проверять его нужно через привычные домены: кто именно инициирует действия, какие права получает агент, где он запускается, к каким директориям, сетям и инструментам имеет доступ, что логируется и как быстро команда увидит аномалию. Из этого вытекает вполне практичный профиль защиты.
Во-первых, нужны четкие правила авторизации и минимальных привилегий: какой репозиторий видит агент, может ли он писать или только читать, разрешено ли ему запускать тесты, миграции или shell-команды. Во-вторых, важна изоляция: контейнер, отдельный runner или выделенное окружение с жестко ограниченными mounts, без лишнего доступа к docker.sock, Kubernetes API и продовым секретам.
В-третьих, нужен сетевой контроль с белыми списками доменов и понятной политикой внешних запросов. И, наконец, обязательны статический анализ кода и конфигов, лабораторные динамические тесты с honeypot-файлами и фейковыми секретами, а также аудит и алерты на нетипичное поведение агента. Такой подход не запрещает внедрение ИИ, а превращает его из модного и плохо предсказуемого инструмента в управляемый компонент инженерной инфраструктуры.
Что это значит на практике: безопасность не должна тормозить внедрение coding-агентов, но и доверять им по умолчанию нельзя. Если вместе с командами разработки заранее собрать единый профиль требований, проверить типовые риски в изолированной среде и зафиксировать политики доступа, то появление нового ИИ-инструмента перестанет каждый раз превращаться в срочную и дорогую экспертизу. Для бизнеса это означает более быстрое внедрение полезной автоматизации без лишнего риска для кода, секретов и внутренней инфраструктуры.
- 29 окт. 2026 г.Агенты учатся на невезении: уроки LLM переносят случайный сбой в решения
- 29 окт. 2026 г.Liquid AI выпустила LFM3: шесть мультимодальных моделей на 2B с контекстом 256K
- 28 окт. 2026 г.AdaPRA поднял Qwen 80B на 24,5 пункта в data science-лидербордах
- 28 окт. 2026 г.AOS-Bench показал: агенты с разницей 0,6 пункта доставляют 54% и 68% задач
От чтения про ИИ-агентов — к запуску своего агента за вечер
Пошаговая сборка автономных агентов и MCP-связок в Hamidun Academy (academy.hamidun.com) (72 часа бесплатно) или мгновенный запуск готовых мультишаговых агентов в облаке Nomad.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.