Habr AI разобрал градиентный спуск на C++ и CUDA через обучение модели на MNIST
Habr AI выпустил четвёртую часть цикла «От MNIST к Transformer» — теперь про градиентный спуск и реальное обучение модели на MNIST. Автор показывает, как без PyTorch собрать цикл обучения на C++ и CUDA, поработать с памятью GPU, обновлением весов и вычислением ошибки. Получается не обзор, а пошаговый разбор того, как нейросеть действительно учится.
AI-обработка оригинала Habr AI; редакция Hamidun News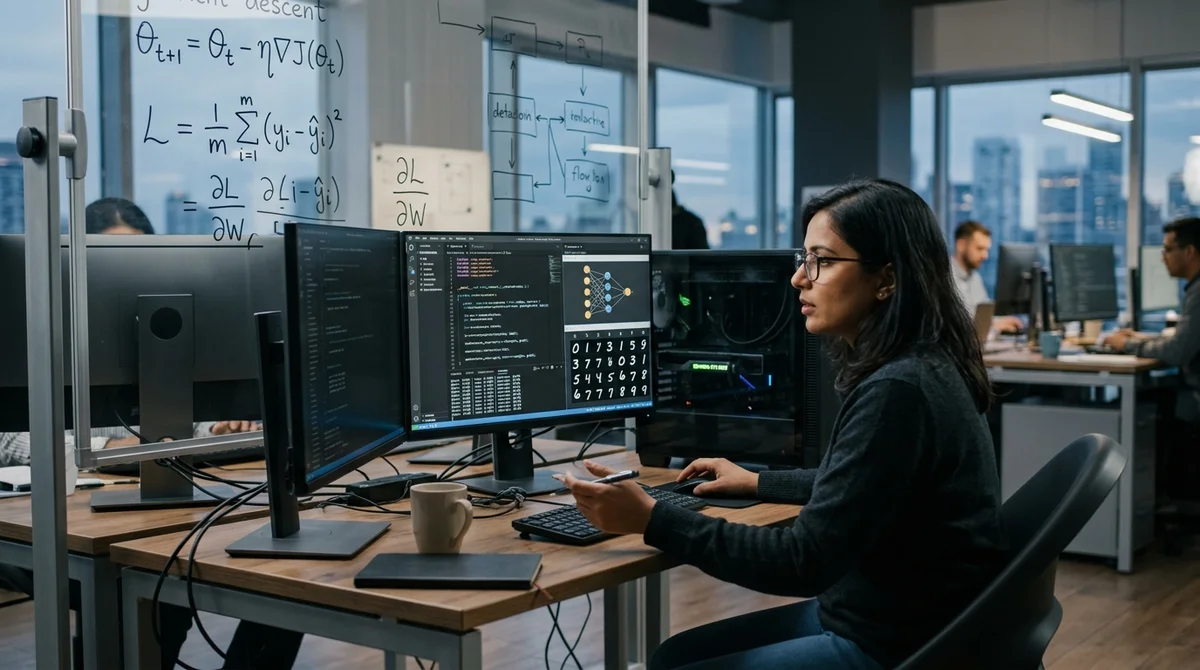
На Habr AI вышла четвёртая часть цикла «От MNIST к Transformer», и в этот раз автор переходит к самому практическому этапу — обучению модели через градиентный спуск. Материал показывает, как без PyTorch собрать базовый цикл обучения на C++ и CUDA и довести модель до распознавания рукописных цифр.
О чём эта часть
Цикл строится как маршрут от минимальных примеров к устройству современных нейросетей. Вместо готовых фреймворков автор последовательно разбирает низкий уровень: CUDA-ядра, память, вычисления на GPU и математику, которая всем этим управляет. В четвёртой части фокус смещается на gradient descent — механизм, без которого модель не учится, а просто делает случайные предсказания.
Это важный шаг, потому что именно здесь разрозненные куски кода превращаются в полноценный процесс обучения. Главная идея статьи — снять эффект «чёрного ящика» с привычных AI-инструментов. Когда разработчик работает только через высокоуровневые библиотеки, обновление весов, вычисление ошибки и движение по поверхности функции потерь часто остаются скрытыми.
Здесь же автор предлагает собрать всё вручную: понять, откуда берётся градиент, как он влияет на параметры и почему даже простая модель требует аккуратной работы с данными и памятью. Для тех, кто хочет разобраться в фундаменте LLM, такой подход полезнее, чем очередной готовый notebook.
Как идёт обучение В центре материала — практическая реализация обучения модели на датасете MNIST.
Автор не ограничивается формулой градиентного спуска, а связывает математику с кодом: как считается ошибка, как обновляются веса и как эти операции укладываются в C++ и CUDA. За счёт этого статья одновременно работает как разбор алгоритма и как пошаговый инженерный разбор по сборке собственного цикла обучения. разбор механики gradient descent без абстракций обучение модели распознавать цифры из MNIST реализация ключевых шагов на C++ и CUDA работа с памятью и вычислениями на GPU * связка математики, кода и архитектуры ускорителя Отдельно ценен акцент на том, что обучение — это не одна формула, а цепочка зависимых решений.
Нужно правильно организовать данные, не потерять производительность на копированиях, понимать цену каждой операции на GPU и следить за тем, как меняются параметры модели от шага к шагу. На таком масштабе особенно хорошо видно, почему современные ML-фреймворки настолько сложны внутри: они автоматизируют не магию, а огромный объём инженерной рутины.
Зачем идти в низкий уровень
Для широкой аудитории MNIST может показаться слишком простым примером, но в этом и смысл. На компактной задаче легче увидеть базовые принципы, которые потом масштабируются до более серьёзных архитектур, включая Transformer. Если понять, как считается градиент, как обновляются веса и как это исполняется на GPU, многие «волшебные» свойства больших моделей перестают казаться необъяснимыми. Статья фактически напоминает: путь к LLM начинается не с prompt engineering, а с понимания вычислительной основы.
«Только так можно по-настоящему понять, как работают LLM и что за этим стоит».
Материал также хорошо попадает в запрос на инженерное образование вокруг AI. Сейчас рынок переполнен инструментами, которые дают быстрый результат, но редко объясняют внутреннее устройство. Серия «От MNIST к Transformer» делает обратное: она замедляет процесс и заставляет смотреть на детали — от устройства памяти до логики обновления параметров. Для студентов, ML-инженеров и backend-разработчиков, которым важно понимать ограничения железа, это полезный формат.
Что это значит
Интерес к низкоуровневой AI-разработке растёт: разработчикам уже недостаточно просто вызвать модель через API. Такие материалы показывают сдвиг в сторону более глубокого понимания обучения нейросетей, где C++, CUDA и математика снова становятся ключевыми навыками, а не факультативом.
- 29 окт. 2026 г.SpaceX получила $40 млрд на GPU от Apollo и обещает неооблакам вымирание
- 29 окт. 2026 г.Black Forest Labs выпустила FLUX.3 Klein: 1024×1024 за 2 секунды на H100
- 28 окт. 2026 г.Liquid AI выпустила LFM2.5-24B-A2B: агент с 2B активных параметров
- 28 окт. 2026 г.PyTorch 2.15 ускорил MoE-модели на Mac в 5–6,5 раза и принёс FP8
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.