Claude и иллюзия честности: почему люди доверяют чат-ботам больше собственного суждения
Новая колонка о Claude разбирает опасную привычку: пользователи просят бота быть «предельно честным», загружают пару авторитетных статей и принимают его оценки за реальную экспертизу. В примере с абсурдными бизнес-идеями модель все равно выдает убедительные баллы и рыночные аргументы. Главная мысль проста: уверенный тон LLM слишком часто подменяет критическое мышление человека.
AI-обработка оригинала Habr AI; редакция Hamidun News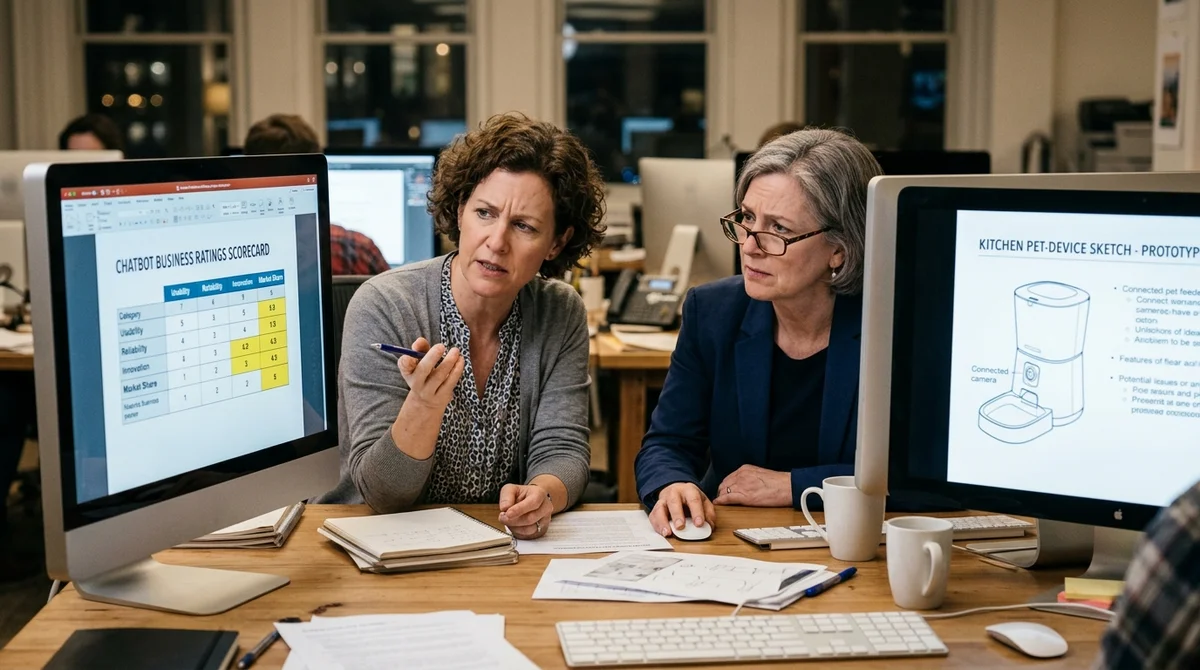
Колонка о Claude разбирает не очередную ошибку модели, а более неприятную вещь — готовность людей принимать уверенный ответ чат-бота за настоящее суждение. Поводом стал кейс, где журналист попытался «настроить» ИИ на честность и проверить, сможет ли тот трезво оценивать бизнес-идеи.
Промпт как ритуал
Автор исходного кейса предложил простой рецепт: дать модели роль опытного бизнес-аналитика, загрузить в чат две статьи Harvard Business School и отдельно потребовать от бота «предельной честности». Логика такая: если ИИ заранее назначить скептиком и снабдить правильными материалами, он якобы перестанет быть генератором правдоподобного текста и начнет вести себя как суровый эксперт. Колонка спорит именно с этим допущением: уверенный промпт не меняет природу модели, а только меняет тон ее ответа.
- Назначить модели роль эксперта Подгрузить авторитетные материалы Сформулировать запрос как бизнес-исследование * Добавить требование быть «предельно честной» Проблема в том, что такой ритуал слишком легко принимают за калибровку мышления. Пользователю кажется, что он добавил системе строгость и научный авторитет, хотя на практике он лишь сузил стиль, в котором бот будет выдавать знакомые шаблоны: рыночные тренды, конкурентную среду, риски и потенциал роста. Если ответ звучит как речь консультанта, это еще не значит, что перед нами появилось понимание предмета.
Проверка на абсурде Первой проверкой стала заведомо слабая идея — лидерский коучинг для собак.
В нормальной человеческой оценке такой проект должен развалиться еще на уровне базовой логики: собака не управляет командами, не строит карьерную траекторию и не осваивает менеджерские навыки. Но Claude поставил идее 3 из 10. Вместо того чтобы увидеть в этом очередной компромиссный ответ модели, автор кейса воспринял тройку как знак того, что система «откалибрована» и умеет быть жесткой, но справедливой.
После этого в дело пошла уже «серьезная» задумка — Cat-Away AI, устройство с компьютерным зрением, которое должно распознавать кота на кухонной поверхности и автоматически брызгать в него водой. Модель оценила идею на 7,5 из 10 и добавила типичный набор деловых аргументов: рынок pet tech растет, конкурентная среда выглядит слабой, а существующие решения грубы и неэффективны. Для автора колонки это и есть ключевой сбой: бот не разобрал идею по сути, а просто красиво упаковал сомнительный проект в язык стартап-презентации.
Откуда берется доверие Главная мысль текста не в том, что чат-боты иногда ошибаются.
Ошибка глубже: люди все чаще делегируют машине финальное суждение и принимают статистически вероятный, социально гладкий ответ за экспертизу. У больших языковых моделей хорошо получается имитировать компетентность, потому что они воспроизводят знакомые формы речи — спокойный тон, деловой жаргон, взвешенные оговорки и аккуратные баллы. Когда такая подача совпадает с ожиданиями пользователя, возникает опасная иллюзия, будто машина действительно «поняла» идею. Автор колонки связывает этот кейс с более широким трендом: рынок уже заполняют ИИ-консультанты, ИИ-рекрутеры, ИИ-коучи и другие сервисы, где правдоподобный текст продается как содержательное суждение. Отдельно подчеркивается разница между машинным обучением и человеческим интеллектом: первое ищет закономерности в огромных массивах данных, второе связано с пониманием контекста, намерений и смысла. Именно поэтому короткая инструкция «будь честной» не превращает LLM в мыслителя.
«Вы способны думать. Он — нет.»
Что это значит
История с Claude важна не как очередной спор о галлюцинациях, а как предупреждение о новой привычке пользователей. Чем убедительнее становятся ответы LLM, тем выше риск, что человек перестанет проверять выводы и начнет считать форму доказательством сути. Для медиа, стартапов и команд, которые используют ИИ в аналитике, правило остается прежним: бот может ускорить черновую работу, но критическое мышление он не заменяет.
- 29 окт. 2026 г.Anthropic в S-1 показала: 11 900 клиентов платят от $100 тысяч в год
- 28 окт. 2026 г.CNN 2015 года обошла GPT-6 Astra и Claude Fable 5.1 в диагностике рака кожи
- 28 окт. 2026 г.Keystone убрал имя модели из кода: open-source LLM-шлюз добавляет 0,64 мс
- 28 окт. 2026 г.Wired за сутки протестировал 6 ИИ-агентов: Dots лидирует, Gemini Spark провалил обед
Внедряйте ИИ быстрее рынка вместе с инженерами и фаундерами
Внутри Vibe Club (hamidun.com/club): еженедельные живые мастермайнды и разборы архитектуры с Жемалом Хамидуном, закрытый Tech Radar, LMS и обновляемая база из 370+ боевых скиллов.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.