Почему GPT ошибается при подсчёте букв: секрет токенизации
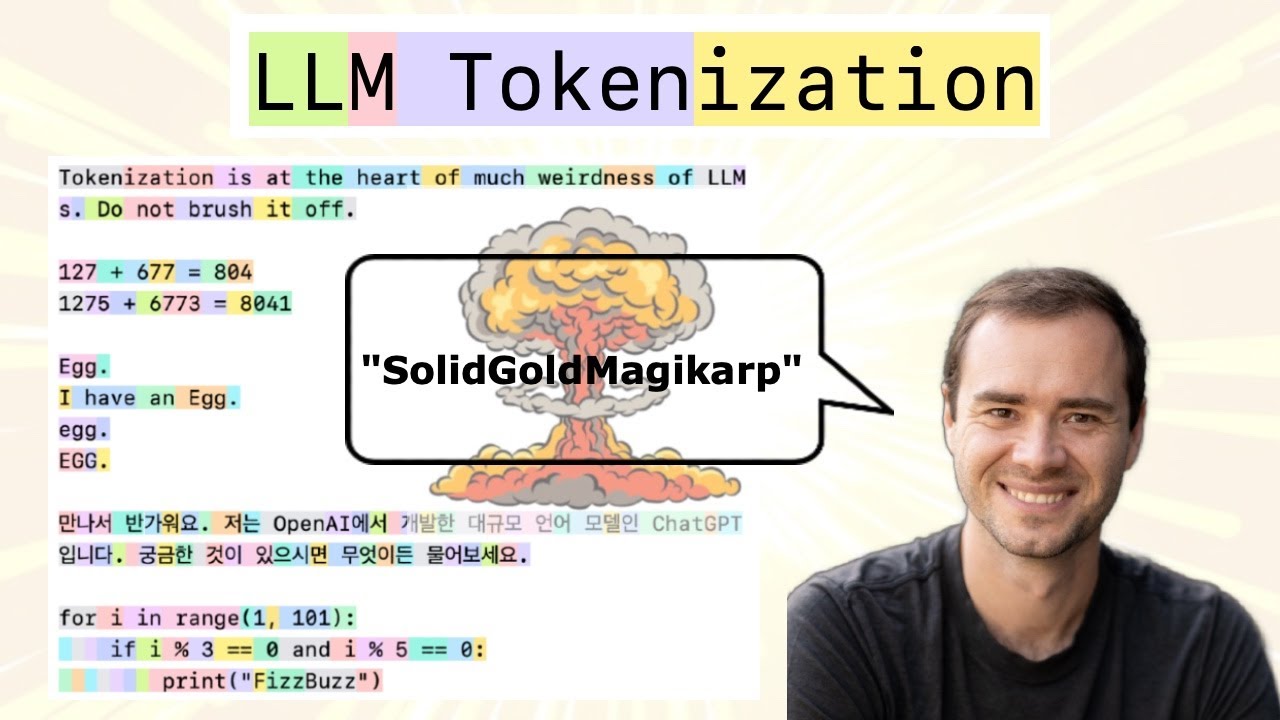
LLM обрабатывают текст как последовательность числовых токенов, а не как отдельные буквы. Это объясняет странный парадокс: GPT может легко запутаться при простом подсчёте букв в словах вроде strawberry. Понимание токенизации — это ключ к написанию более эффективных промптов, точному предсказанию странного поведения моделей, оптимизации контекстного окна и работе с многоязычным текстом.
AI-обработка оригинала Habr AI; редакция Hamidun News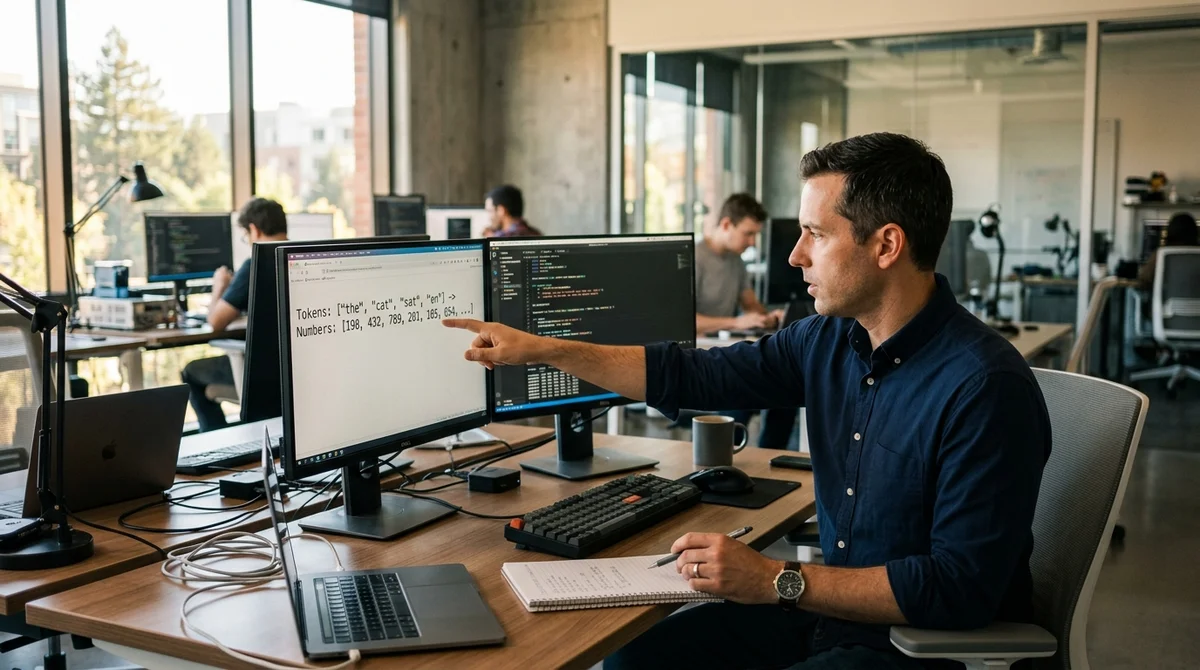
Когда вы пишете промпт в ChatGPT, вы видите обычный текст из букв. Но модель видит совсем другое — последовательность чисел, называемых токенами. Это расхождение создаёт странные эффекты: GPT может не понять, сколько букв в слове strawberry, или запутаться при простом подсчёте.
Как LLM видят текст Для нейросетей текст — не набор букв, а последовательность числовых кодов.
Каждому токену соответствует число, и модель работает только с числами, никогда не видя саму букву. Это как если бы вы читали книгу через систему, которая сначала переводит слова в коды, вы их обрабатываете, а потом коды переводят обратно в текст. Одно частое слово может быть одним токеном, редкое слово разбивается на несколько кусков. Например, «hello» кодируется одним числом, а «strawberry» может быть тремя или четырьмя числами. В русском языке ситуация ещё сложнее — из-за богатой морфологии слова разбиваются менее эффективно.
Почему это создаёт проблемы
Расхождение между тем, как люди видят текст, и тем, как его видит модель, приводит к целому ряду неприятностей: Ошибки в подсчётах: GPT не может просто посчитать буквы, потому что работает с числами, а не символами Нечитаемость редких слов: редкие буквосочетания разбиваются на несколько токенов, модель видит их как отдельные куски Языковая асимметрия: английский разбивается на токены эффективнее, чем русский, китайский или арабский Расход контекста: если слово разбилось на 3 токена вместо 1, ваш промпт занимает больше места в окне контекста * Непредсказуемое поведение: модель может вести себя странно с числами, кодами и редкими именами, потому что они разбиты на кусочки ## Алгоритм за кулисами За токенизацией стоит алгоритм Byte Pair Encoding (BPE). Вот как он работает: сначала текст разбивается на каждый символ как отдельный токен. Затем алгоритм смотрит, какие пары символов встречаются чаще всего, и объединяет их в новый токен.
После этого ищет частые пары получившихся токенов — и опять объединяет. Это повторяется тысячи раз. В результате в словаре GPT оказывается около 50 тысяч токенов.
Частые слова и части слов — это отдельные токены, редкие буквосочетания остаются раздробленными. Это не идеально, но эффективнее, чем кодировать каждую букву отдельно.
Что это значит Понимание токенизации меняет подход к работе с LLM.
Если знать, что модель будет запутана в подсчётах букв, можно попросить её работать иначе — например, сначала распечатать буквы отдельно, потом их считать. Это не панацея, но помогает писать более надёжные промпты. Знание о токенизации полезно при оптимизации длинных промптов — вы можете предсказать, где модель «потратит» токены впусту. Это важно для любого, кто работает с LLM на глубоком уровне, от промпт-инженеров до разработчиков приложений на базе нейросетей.
- 29 окт. 2026 г.pgvector против Qdrant: бенчмарк на 100 000 векторов размерности 1536
- 28 окт. 2026 г.Keystone убрал имя модели из кода: open-source LLM-шлюз добавляет 0,64 мс
- 28 окт. 2026 г.Wired за сутки протестировал 6 ИИ-агентов: Dots лидирует, Gemini Spark провалил обед
- 28 окт. 2026 г.Anthropic превращает Claude Code в платформу: Claude Mods переворачивают обвязку агента
Соберите рабочего ИИ-агента или сервис своими руками без ручного кода
В Академии Жемала Хамидуна (academy.hamidun.com) открыт бесплатный 72-часовой тест-драйв: интерактивные скетч-уроки по Claude Code и Cursor, живой Tech Radar и готовые шаблоны агентов.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.