Hugging Face Blog
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации

Liquid AI выпустила LFM2.5-24B-A2B: агент с 2B активных параметров
Liquid AI открыла веса MoE-модели на 24B параметров, из которых активны всего 2B. На ноутбуке с M5 Max она выдаёт 184 ток/с, на одной B300 — свыше 21 тыс. ток/с.

PyTorch 2.15 ускорил MoE-модели на Mac в 5–6,5 раза и принёс FP8
Команда Hugging Face переписала критичные операции MPS на Metal: Qwen3.6-35B-A3B на M3 Ultra выросла с 9,4 до 61,3 токенов/с, а пик памяти Wan2.2 упал с 270 до 8 GiB.

NVIDIA Kumo Relational обходит supervised ML на 41 задаче без обучения
NVIDIA выпустила Kumo Relational: предобученная модель предсказывает отток и спрос прямо по реляционной базе за один проход и на SAP SALT опережает AutoGluon на 8% MRR.

Швейцарский Apertus 1.5 получил зрение, слух и контекст в 262 тысячи токенов
Проект Swiss AI выпустил Apertus 1.5 на 8B и 70B под Apache 2.0: мультимодальность через токенайзер, режим размышлений, контекст в 4 раза длиннее и полностью открытые данные.

Microsoft и Hugging Face обучили Qwen3.8-27B на оценках базы: с 38 до 107 задач
Проверки итогового состояния базы данных стали наградой для GRPO: за 50 шагов Qwen3.8-27B поднял pass@1 с 51,70% до 60,78% и почти втрое увеличил число задач с 20/20.

Dharma-AI урезала словарь Qwen3-4B и снизила стоимость инференса на 77%
Бразильская команда Dharma-AI пересобрала токенизатор Qwen3-4B под одну задачу. Ответ модели сократился с 350 до 101 токена, а качество выросло с 0,703 до 0,810.

Reflection выпустила Beam: открытая MoE-модель на 501B параметров под Apache 2.0
Новая американская лаборатория Reflection открыла Beam: 501B параметров, 23B активных на токен, контекст 1M и лицензия Apache 2.0. Модель заточена под кодинг и агентов.

Meta открыла Muse Spark Open: MoE на 816 млрд параметров и контекстом 1 млн токенов
Meta выпустила open-weight модель Muse Spark Open: 816 млрд параметров, 42 млрд активных на токен, текст, картинки, аудио и видео на входе, заточка под агентный кодинг.

GPU простаивают как самолёты: Hugging Face объясняет скрытые потери AI-команд
Hugging Face сравнивает незагруженные GPU с приземлёнными самолётами и показывает, почему плохой GPU-менеджмент обходится AI-командам в сотни тысяч долларов в год.

Nunchaku Lite: 4-битная генерация изображений в Diffusers — до 50% меньше VRAM
Hugging Face интегрировала 4-битный инференс Nunchaku Lite прямо в Diffusers: до 50% меньше видеопамяти и на 30% быстрее генерация изображений одной строкой кода.

NVIDIA открыла датасеты Nemotron: 10 триллионов токенов для обучения AI-агентов
NVIDIA выпустила датасеты Nemotron с 10+ триллионами токенов и 2,4 млрд синтетических персонажей для обучения AI-агентов на реальных сценариях и сбоях инструментов.

Hugging Face: transformers-бэкенд в vLLM теперь работает с нативной скоростью
Hugging Face объявила о паритете производительности: флаг --model-impl transformers даёт нативную скорость vLLM на 450+ архитектурах без переписывания кода.
Hugging Face запустила облако без платы за трафик
Интеграция SkyPilot и Hugging Face Storage позволяет обучать модели на любом облаке, храня веса и датасеты по $12-18/ТБ/мес без платы за исходящий трафик.
Microsoft запустила Foundry Managed Compute: тысячи моделей Hugging Face одним кликом
Microsoft объединила Azure Foundry с каталогом Hugging Face: тысячи открытых моделей теперь разворачиваются в облаке одним кликом с корпоративной безопасностью и единым биллингом.
LeRobot v0.6.0 от Hugging Face: роботы учатся предсказывать будущее и оценивать себя
Hugging Face выпустила LeRobot v0.6.0 с world-model политиками, reward-моделями для автооценки задач и шестью новыми бенчмарками — замыкая полный цикл обучения роботов.
Hugging Face обновила Kernels: доверенные издатели, подписание кода и агентная разработка
Hugging Face 6 июля 2026 года выпустила крупное обновление Kernels: ядра стали отдельным типом репозитория на Hub, добавлены доверенные издатели и подписание кода через Sigstore.
Нейросеть для речи Gemma 4 в реальном времени от Hugging Face
Hugging Face и Cerebras представили открытый конвейер речь-в-речь на Gemma 4 с предсказуемыми задержками — система уже применяется в более чем 9000 роботах Reachy Mini.
PaddleOCR выпустила PP-OCRv6: распознавание текста на 50 языках от 1,5 до 34,5 млн параметров
PP-OCRv6 от Baidu PaddlePaddle: универсальный OCR на 50 языков в трёх конфигурациях от 1,5 до 34,5 млн параметров с приростом точности +4,6–5,1 п.п. к предыдущей серверной версии.
ServiceNow: AI-агент сливает корпоративные тайны через цепочку поисковых запросов
Исследователи ServiceNow показали: deep-research агент непреднамеренно раскрывает корпоративные секреты — каждый запрос безобиден, но вся цепочка складывается в мозаику.
Hugging Face сравнила все альтернативы LoRA: кто побеждает в тонкой настройке LLM
Команда Hugging Face протестировала пять PEFT-методов тонкой настройки LLM — от DoRA до GaLore — и выяснила, когда LoRA можно обойти и за счёт чего именно.
Гибридные модели лучше предсказывают смысловые слова, чем трансформеры — исследование Allen AI
Allen AI сравнила архитектуры OLMo 3 и OLMo Hybrid: гибридные модели точнее предсказывают существительные, глаголы и прилагательные, но уступают трансформерам на повторяющихся фрагментах текста.
Деплой языковых моделей без DevOps: интеграция Hugging Face с vLLM
Hugging Face добавила поддержку vLLM в платформу HF Jobs: теперь production-ready сервер вывода для любой модели с Hub разворачивается одной командой CLI.
ИИ для оценки моделей: AllenAI запустила olmo-eval
AllenAI выпустила открытый инструментарий olmo-eval для непрерывной оценки языковых моделей в ходе тренировочного цикла — чекпоинт за чекпоинтом.
North Mini Code — нейросеть для кода от Cohere
Cohere выпустила North Mini Code — 30-миллиардную модель, специально обученную на программировании и работе с AI-агентами. Модель бесплатна и доступна всем.
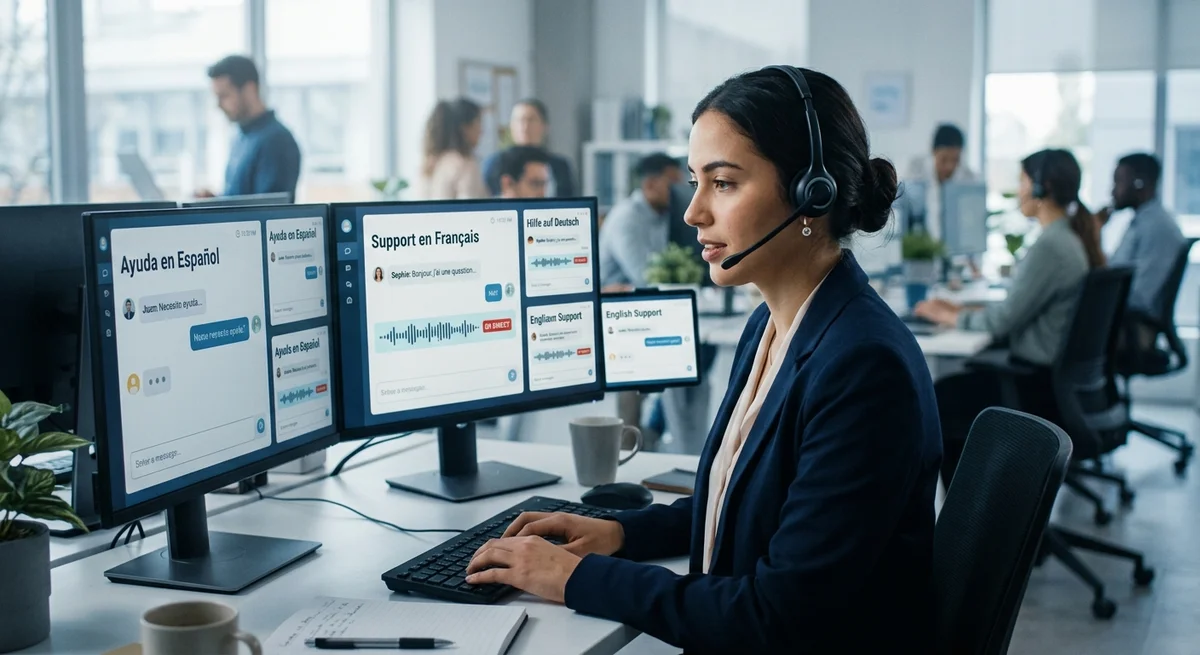
Голосовые ИИ-агенты теряются в двуязычии: исследование
Исследование ServiceNow-AI показало, что большинство голосовых систем ещё не готовы обслуживать двуязычных клиентов, хотя ElevenLabs и AssemblyAI демонстрируют лучшие результаты.
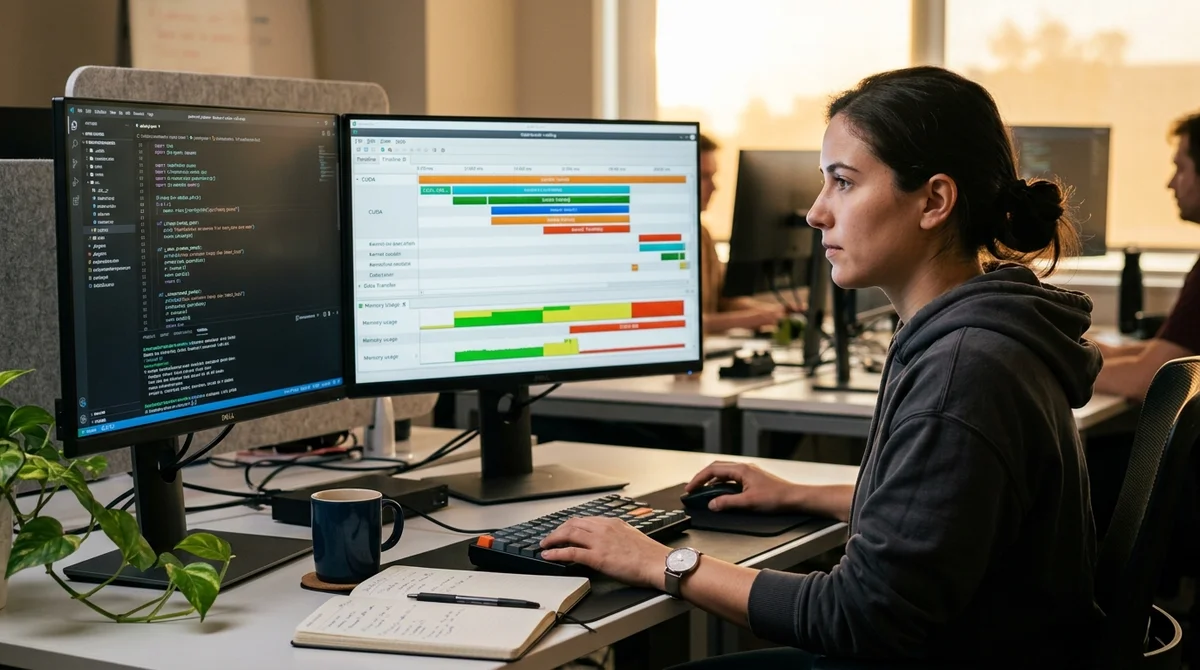
Как ускорить модели PyTorch: практическое руководство torch.profiler
Hugging Face рассказала о torch.profiler — встроенном инструменте PyTorch для анализа производительности. Он помогает найти узкие места в обучении и инференсе моделей.
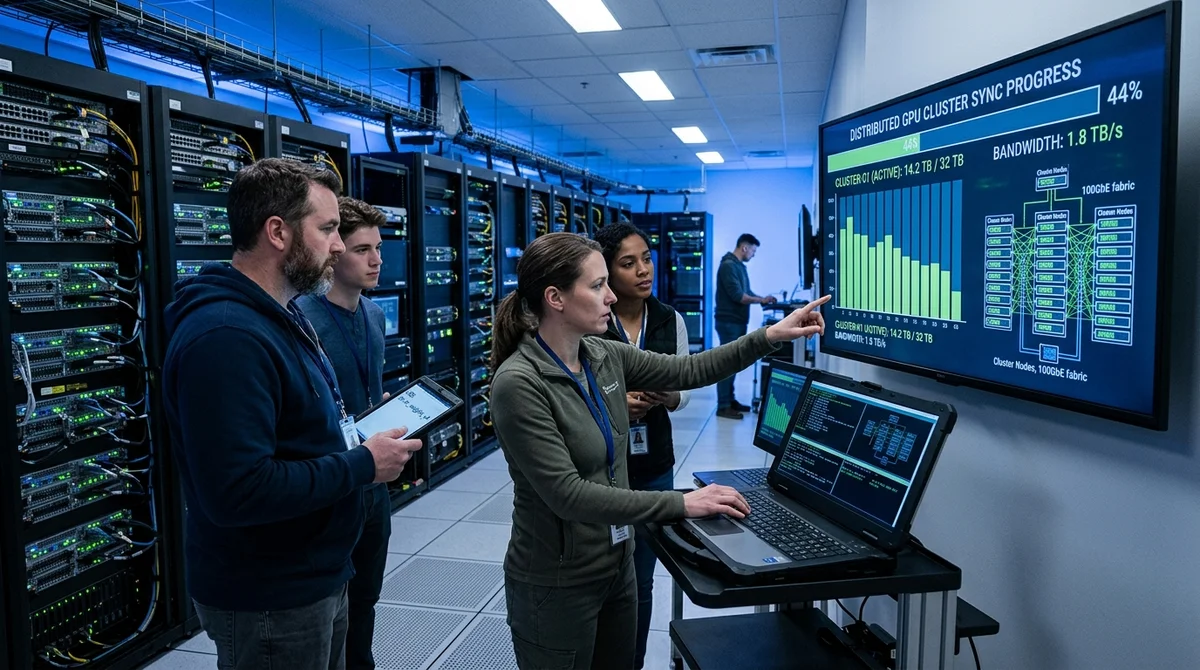
Hugging Face научила TRL доставлять триллион параметров через дельта-веса
Hugging Face добавила Delta Weight Sync в TRL — техника отправляет только изменения весов вместо полных файлов, снижая объём данных в сотни раз при обучении гигантских моделей.
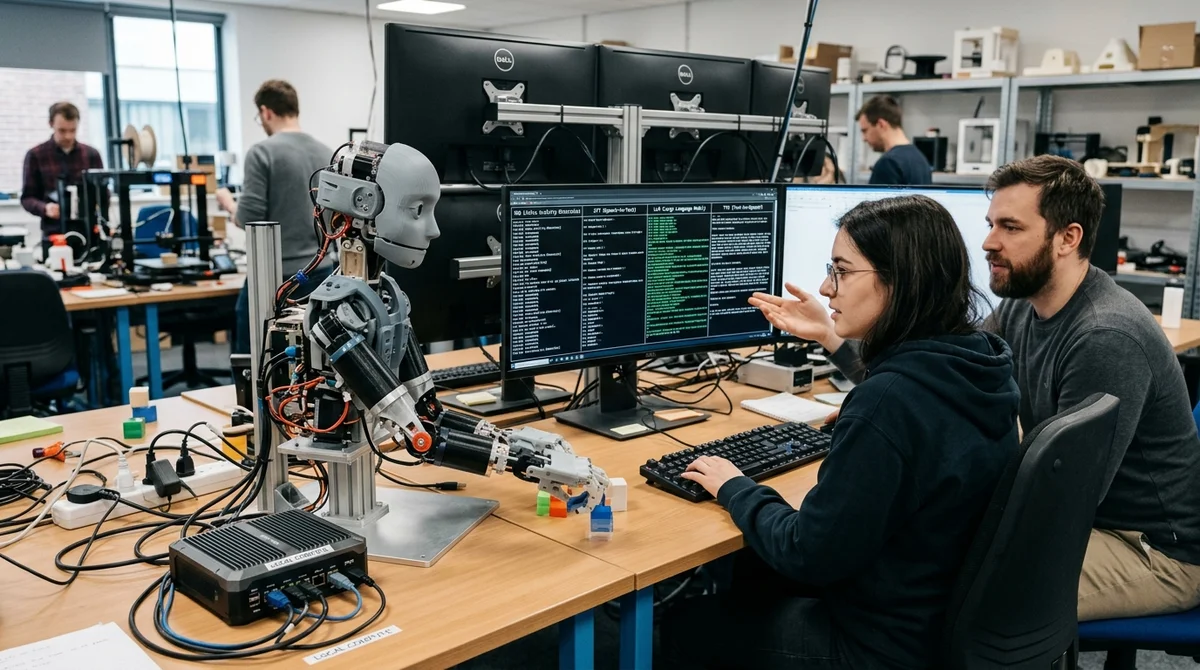
Локальный ИИ на роботе: Reachy Mini работает без облака
Гуманоидный робот Reachy Mini теперь может запускать весь стек распознавания речи локально, без облака и API, благодаря открытым моделям от Hugging Face.
IBM и Artificial Analysis создали бенчмарк: AI-агенты не справились с IT-задачами
Большие языковые модели набрали менее 50% на новом бенчмарке ITBench-AA для оценки способности AI-агентов решать корпоративные IT-задачи. Это показывает, что полная автоматизация IT-работ остаётся далёким будущим.
NVIDIA Nemotron: нейросеть для текста в 6 раз быстрее
NVIDIA представила Nemotron-Labs Diffusion — первые языковые модели, которые генерируют текст параллельно вместо последовательного. В режиме самоспекуляции они работают на 6× быстрее обычных моделей благодаря диффузионно