AI-агенты
AI-агенты — это системы на базе языковых моделей, которые не просто отвечают, а сами планируют шаги, вызывают инструменты и доводят задачу до результата: пишут код, ищут в вебе, бронируют, анализируют. 2026-й стал годом агентов — от кодинг-агентов до автономных исследователей. Здесь собраны все наши материалы про агентный ИИ: запуски, протоколы (MCP, A2A), надёжность и реальные кейсы.
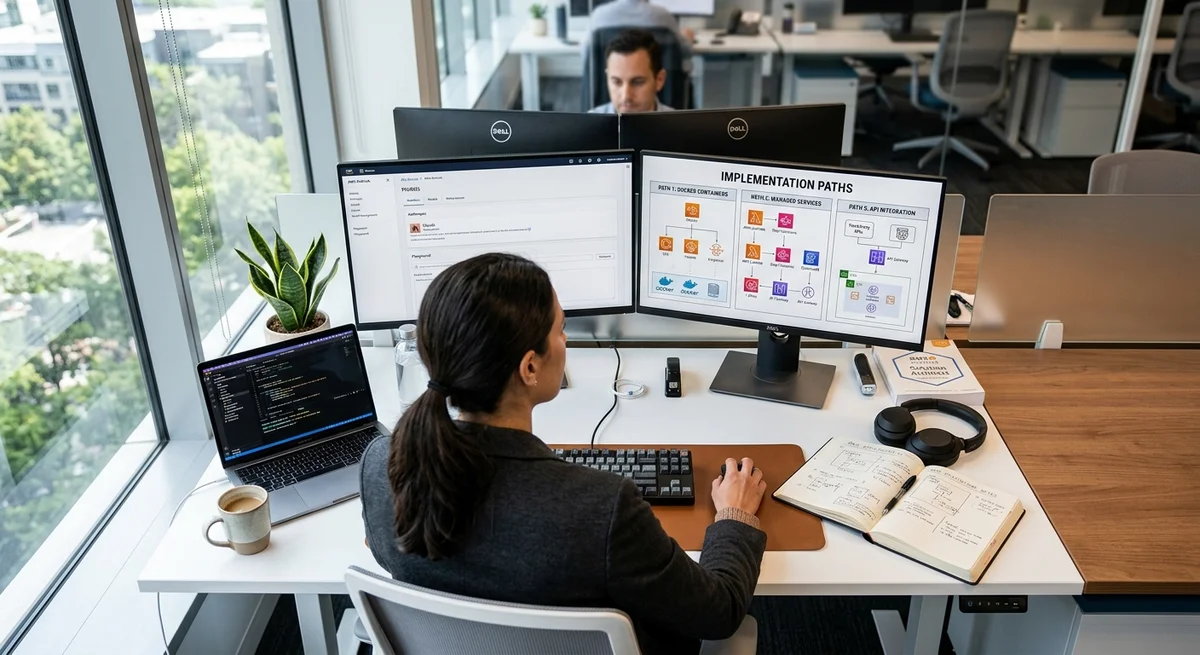
Amazon Bedrock добавляет три способа управлять инструментами ИИ-агентов
AWS Bedrock предложит разработчикам выбор между Docker sandbox, управляемым Code Interpreter и прокси, совместимым с SDK Anthropic, для вызова инструментов из…
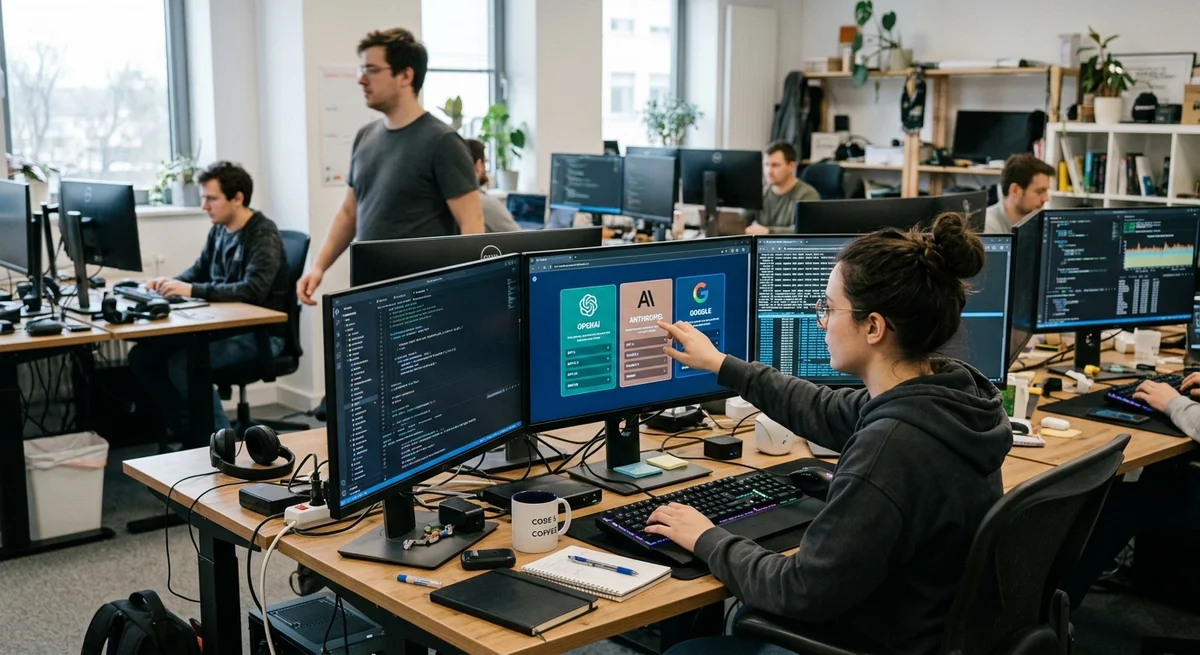
LangChain Deep Agents: как выбрать модель (ChatGPT, Claude, Google)
Deep Agents теперь имеют model-specific профили, которые подстраивают работу под OpenAI, Anthropic и Google. На бенчмарке tau2-bench это дало +10–20 пунктов…
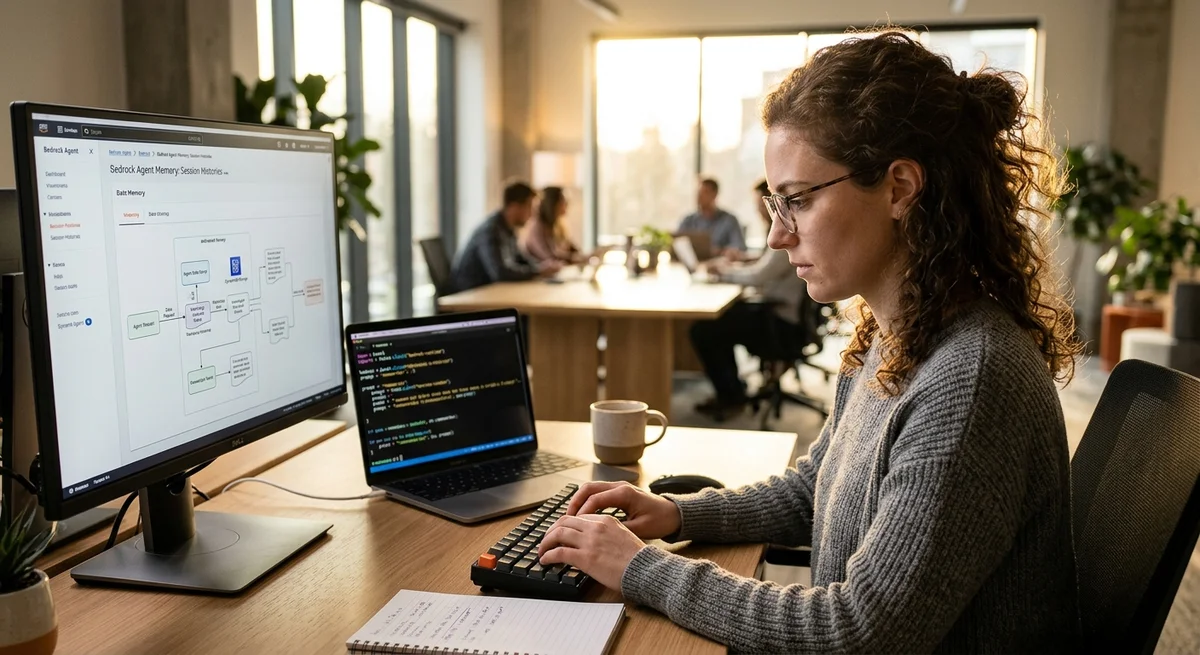
Как дать ИИ-агентам долгую память в Kiro CLI
AWS интегрировала долгосрочную память в Kiro CLI через Bedrock AgentCore Memory и custom MCP-сервер. Теперь AI-агенты в терминале могут помнить контекст предыдущих…
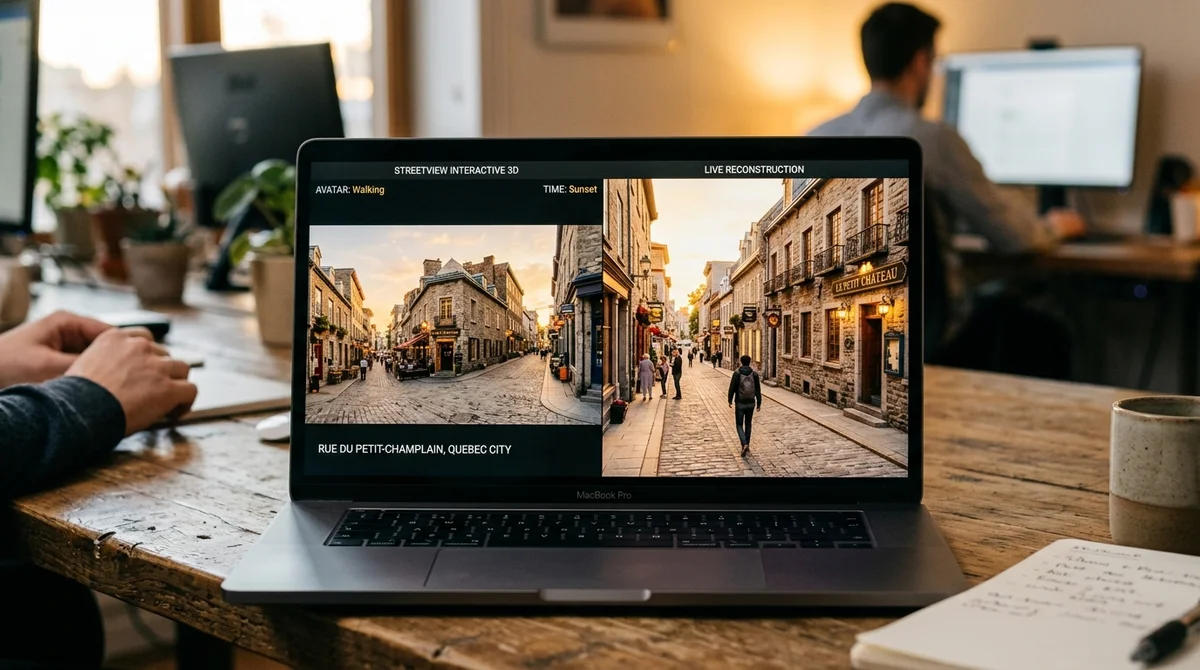
Нейросеть для видео Project Genie интегрируется с Google Street View
Cursor AI: Composer 2.5 научили работать с долгими задачами
Cursor 3: унифицированное рабочее пространство для разработки с AI-агентами
Дженсен Хуан открыл для Nvidia рынок процессоров для AI-агентов стоимостью $200 млрд
Внедрение ИИ: автономный агент закрывает тикеты в разработке
Автономные AI-агенты встроены в CI/CD реальных команд и закрывают живые тикеты в production. Проблема не в качестве кода, а в том, что метрики выглядят идеально…
Cursor запустил окружения для облачных агентов: мультирепо и версионирование
Cursor выпустил инструменты для настройки dev-окружений cloud agents, позволяющие им работать сразу с несколькими репозиториями и полным контекстом проекта.
Composer autoinstall: как старые версии помогают обучать новые
Как Cursor делает AI-агента лучше: от guardrails к динамическому контексту
Трети развёртываний на Vercel теперь делают AI-агенты вместо людей
Языки программирования переделают для AI-агентов, и вот почему
NVIDIA показала различие между оценкой моделей и оценкой AI-агентов
Бенчмарки моделей и оценка агентов решают разные задачи: первые тестируют понимание языка, вторые — реальное поведение системы в действии.
Superset запустил IDE для параллельных AI-агентов на Vercel
Superset запустил IDE для управления несколькими AI-агентами одновременно, запуская до 600 preview-деплойментов в день на инфраструктуре Vercel.