Модели рассуждения
Модели рассуждения — новый класс ИИ, который «думает» перед ответом: тратит дополнительные вычисления во время инференса, строит цепочки рассуждений и решает задачи, недоступные обычным LLM — математику, код, науку. С них началась гонка test-time compute. Здесь — все наши материалы про reasoning-модели: релизы, бенчмарки (GPQA, ARC-AGI), пределы и стоимость.


США сдерживают китайский ИИ, а Кремниевая долина использует Kimi K3 и другие модели
Apple, стартап Thinking Machines и разработчики по всему миру внедряют открытые китайские модели вроде Kimi K3 — а Вашингтон не может защитить лидерство США в…

4 Mac Studio в один кластер: 1,5 ТБ памяти для LLM на триллион параметров
Энтузиаст связал четыре Mac Studio через RDMA поверх Thunderbolt 5 и получил 1,5 ТБ общей памяти, чтобы запускать локально DeepSeek V3 и Kimi K2 Thinking.

Anthropic нашла у Claude нейронные паттерны, похожие на «глобальное рабочее пространство»
Anthropic 6 июля 2026 года опубликовала исследование о том, что в языковых моделях вроде Claude формируется структура, похожая на глобальное рабочее пространство…


LangChain: claude-3.5-sonnet, gpt-4o, o1 и o3-mini протестировали как ReAct-агентов

NVIDIA Developer Blog разобрала техники обучения AI-агентов с подкреплением RL

OpenAI выпустила флагманскую модель GPT-5.6 в трёх версиях — Luna, Terra и Sol

OpenAI выпустила GPT-Realtime-2.1 и mini-версию для голосовых агентов в API

NVIDIA Cosmos 3: модели для рассуждений и действий в физическом мире роботов
NVIDIA представила Cosmos 3 — набор фундаментальных моделей для физического AI, включая world models, reasoning models и action models для роботов и автономных…

Nemotron 3 Ultra достигает уровня Claude Opus в 8 раз дешевле
LangChain показал, что NVIDIA Nemotron 3 Ultra с оптимизированной архитектурой агента может работать на уровне Claude Opus 4.8, но дешевле в 8 раз.


AWS опубликовала 6 подходов к оптимизации MCP-инструментов для экономии контекста

Apple разобралась, когда on-policy distillation помогает обучению моделей

GRAPHEVAL: новый граф-фреймворк обнаружил, что Self-Consistency скрывает ошибки в рассуждениях LLM

TACO: метод устраняет «загрязнение» кредитом при RL-обучении языковых моделей


Исследователи из Alibaba обнаружили DoS-уязвимость в рассуждающих AI-моделях
Учёные из Чжэцзянского университета и Alibaba показали на ICML 2026: логически противоречивые промпты вводят GPT-o3, DeepSeek-R1 и Gemini 2.5 Flash в бесполезные…
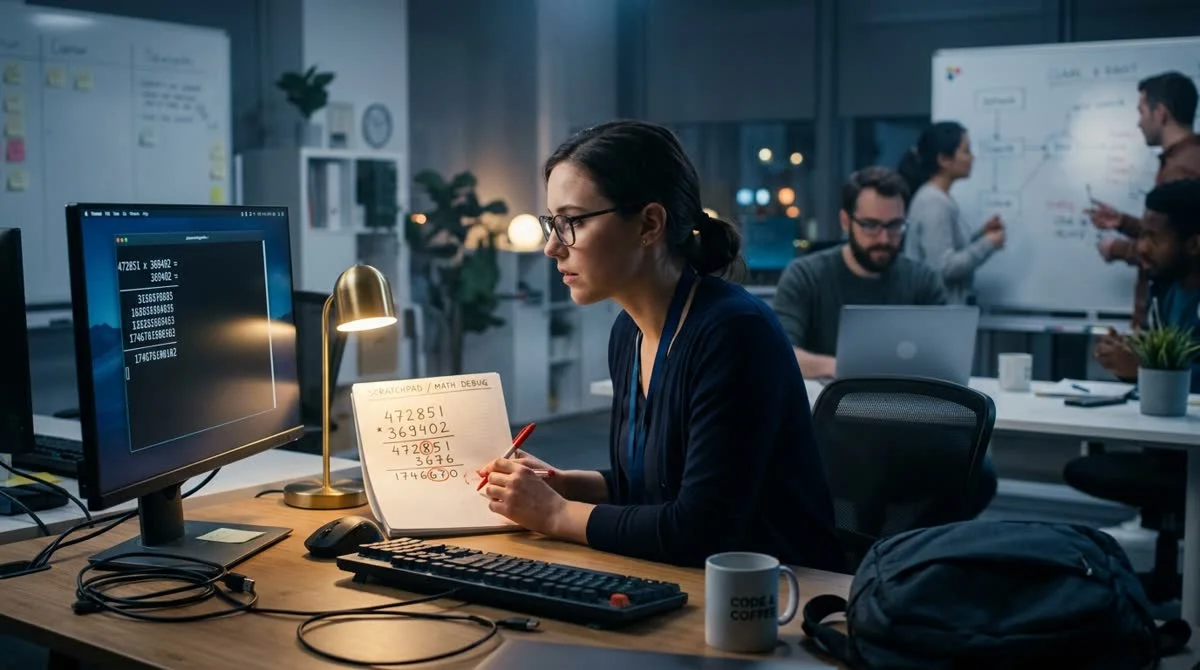
Нейросеть для математики: почему LLM ошибается в расчётах
Языковые модели предсказывают токены, а не вычисляют — поэтому уверенно ошибаются в середине длинных чисел. Разбираем механизм и рассказываем, как индустрия это…