Habr AI
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации
Aurora предлагает манифест устойчивого ИИ — с памятью, идентичностью и развитием
На Habr AI вышел манифест о «устойчивом ИИ»: автор предлагает оценивать системы не по бенчмаркам, а по способности сохранять идентичность, меняться и воспроизводиться во времени.
SENAR вводит ворота качества для ИИ-разработки: как спецификации и метрики снижают ошибки
На Habr вышла новая часть серии о SENAR: автор показывает, как обязательные спецификации, входные и выходные шлюзы и метрики вроде FPSR и MIR снижают число багов и ручных правок.
В OpenWebUI разобрали, как связать System Prompt, Skills и MCP Tools для проверки ссылок
На примере бота техподдержки в OpenWebUI показали, зачем разделять системный промпт, Skills и MCP Tools, если нужно не только сгенерировать ссылку, но и проверить, что она реально открывается.
Anthropic изменила характер Claude Opus 4.7 — и часть разработчиков увидела регресс
После релиза Claude Opus 4.7 Anthropic пообещала более прямую и точную модель, но часть разработчиков столкнулась с лишними спорами, ростом расхода токенов и поломкой старых промптов.
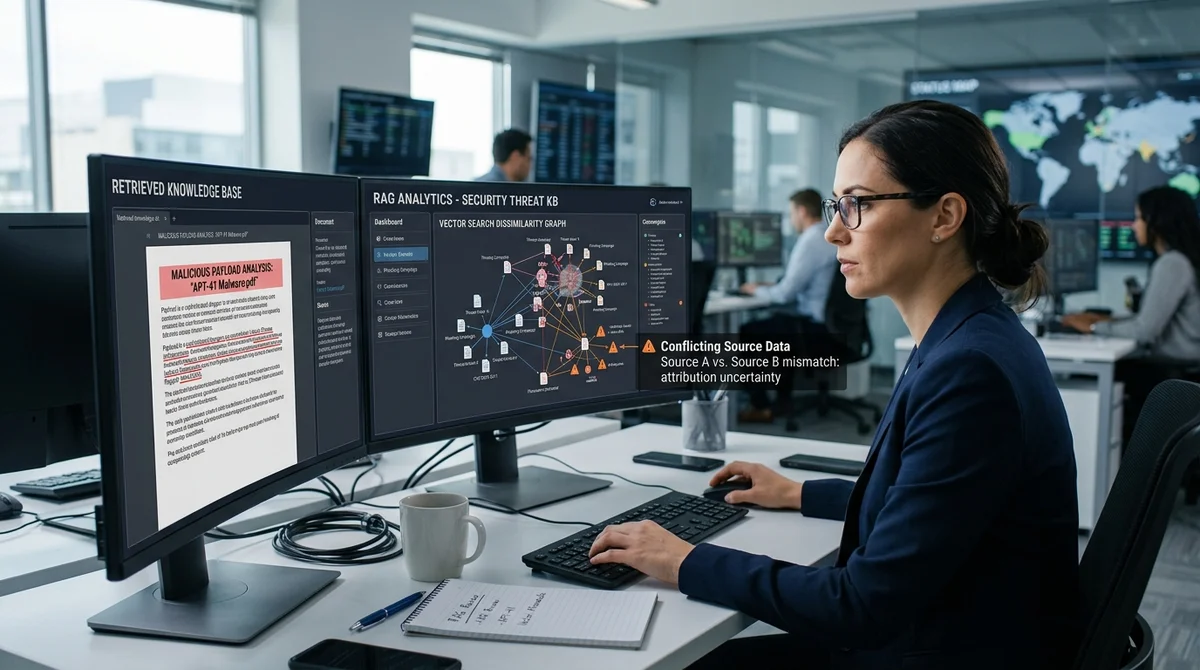
Как пять документов могут сломать RAG-систему и превратить базу знаний в канал атаки
RAG снижает галлюцинации, но доверенный контекст из базы знаний сам становится точкой атаки: нескольких отравленных документов хватает, чтобы увести ответы модели и обойти защиту.
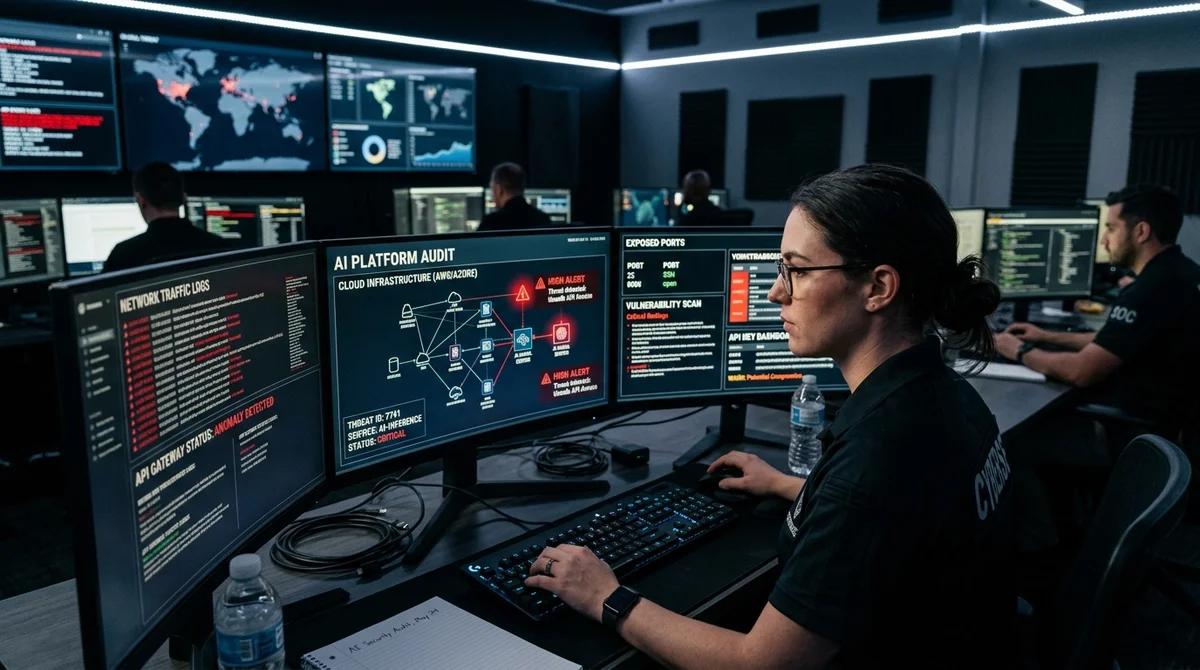
Habr AI разобрал, как один открытый порт в LLM-платформе ведёт к ключам и инфраструктуре
Команда аудита безопасности проверяла RAG-сервис с десятками тысяч пользователей, не пробила сложные цепочки атак, но через открытый порт получила доступ к ключам и инфраструктуре.
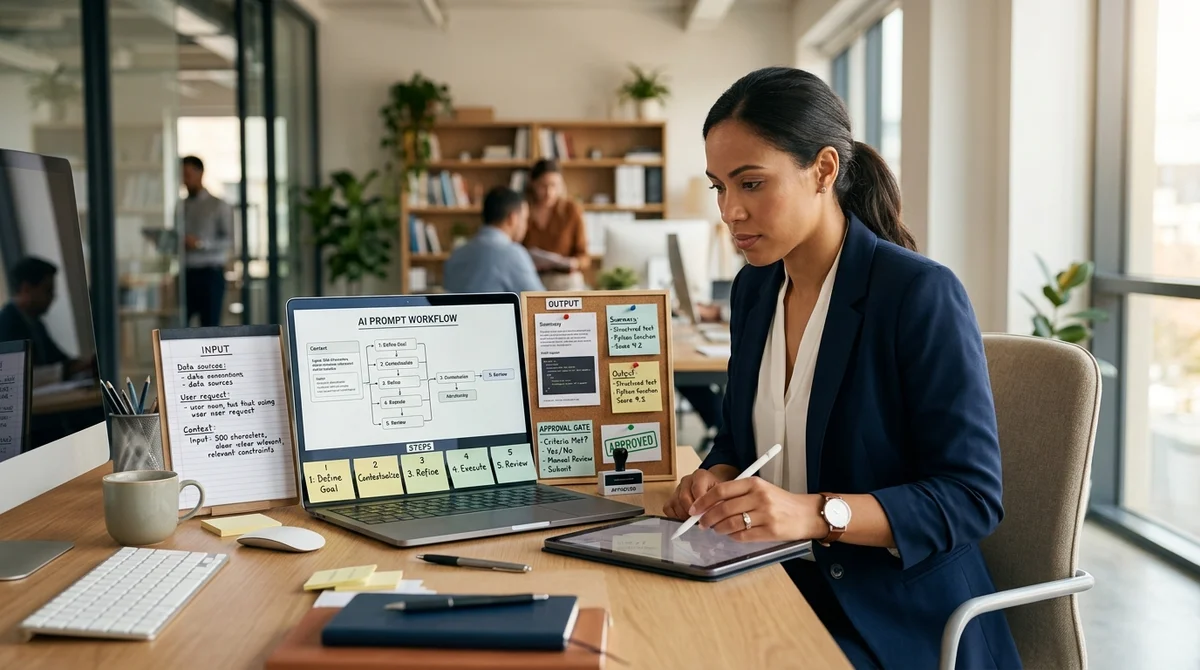
Anthropic Claude не спасает от плохого ТЗ: почему AI выдает убедительный, но слабый результат
На примере Claude автор показывает, что AI чаще ускоряет выпуск правдоподобных ответов, чем полезного результата, если задача не разложена на вход, этапы, выход и критерии приемки.
Как российский разработчик несколько дней запускал Gemini — и что наконец сработало
Российский программист потратил несколько дней на запуск Gemini из России через VPN, перепробовал десятки вариантов и задокументировал каждый шаг — что не работало и что в итоге помогло.
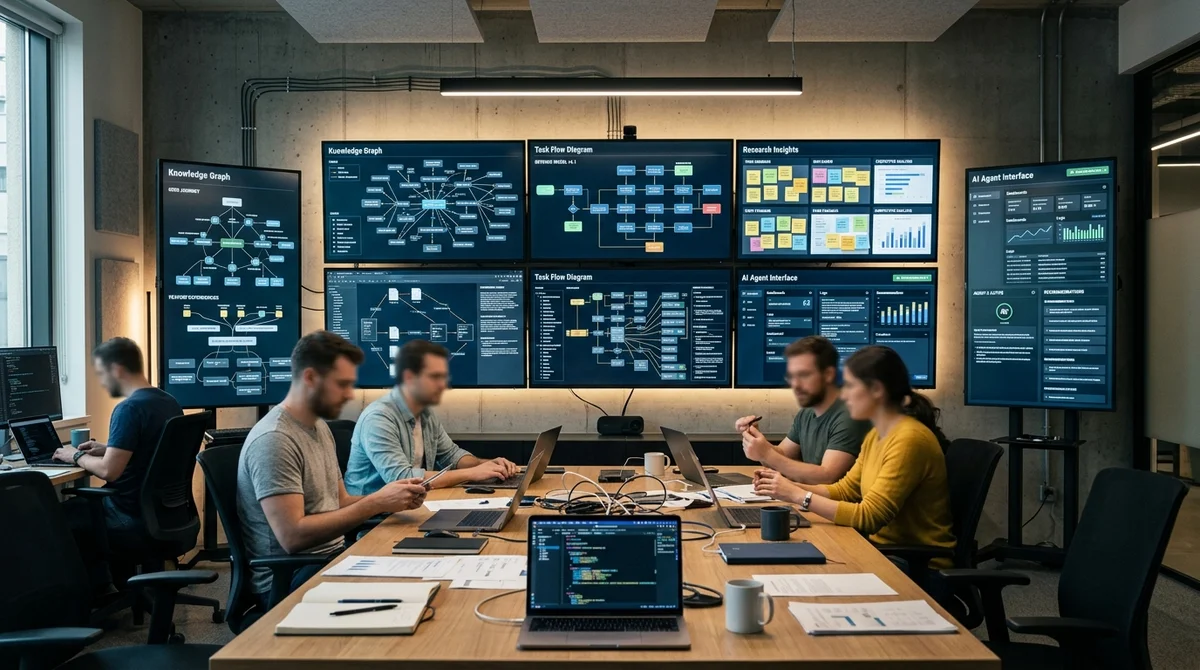
Product Graph и память агентов: почему ИИ не спасает продукт без структуры знаний
Разбор о Product Graph объясняет, почему даже сильные ИИ-агенты бесполезны без общей памяти продукта и как связанная структура знаний снижает хаос в командах.
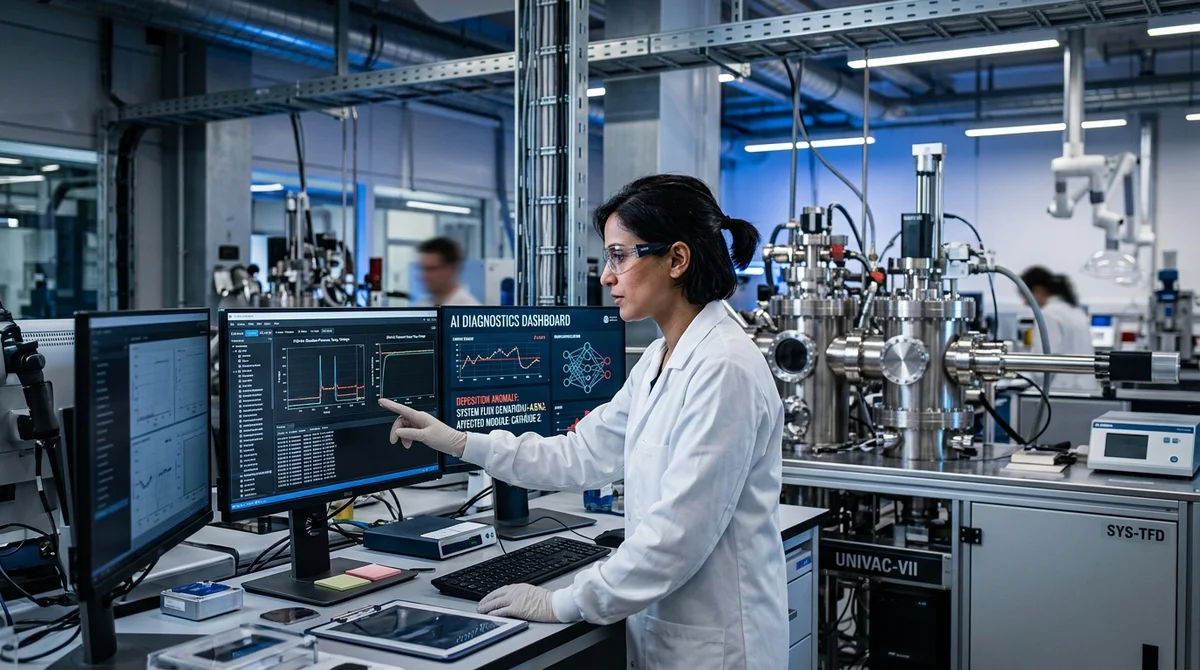
Лаборатория за шесть лет: от флешек и тетрадей до AI, который находит скрытые дефекты
История о том, как одна лаборатория шесть лет строила цифровую инфраструктуру — и в итоге получила AI, который читает логи напыления и заранее находит скрытые дефекты оборудования.
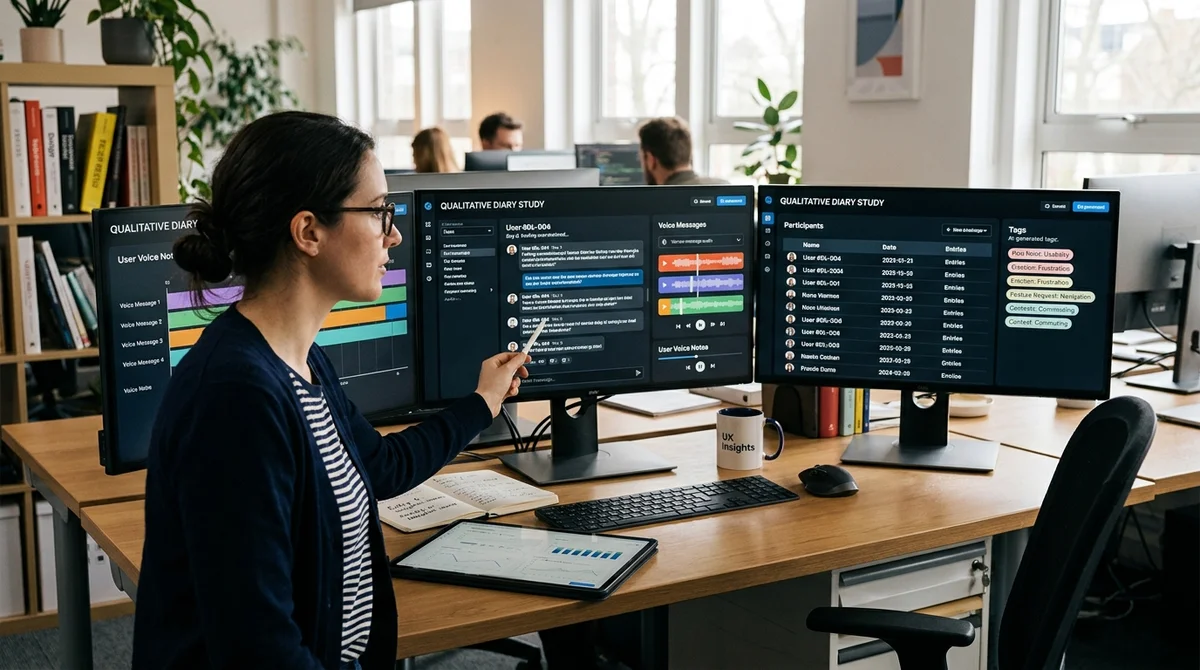
Как AI изменил дневниковое исследование: три компромисса, от которых отказались
Команда UX-исследователей объяснила, как AI позволил отказаться от компромиссов с выборкой, длительностью и глубиной анализа — без урезания ценности метода.
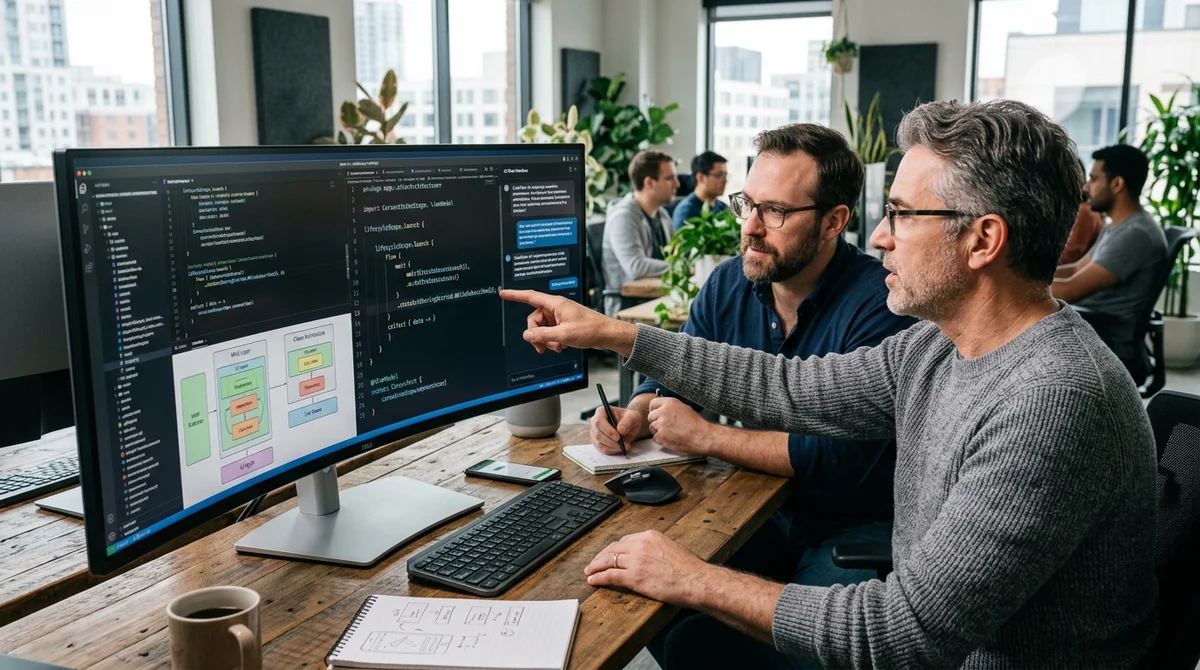
Марчин Москала разобрал GeminiAI: что аудит показал о корутинах и архитектуре Android
Автор open-source клиента GeminiAI рассказал, как его проект прошёл аудит у Марчина Москалы и почему именно ошибки в корутинах стали главным тестом зрелости Android-архитектуры.
Anthropic: утечка исходников Claude Code раскрыла сложную агентную архитектуру
Утекший через sourcemap код Claude Code показал, что продукт Anthropic давно вырос из «CLI для чата» в платформу с субагентами, памятью, remote-режимами и жёсткой shell-безопасностью.
Сбер объяснил, почему бизнесу нужен слой AI Overlay вместо перестройки отделов
Сбер показал, почему точечное внедрение генеративного ИИ редко приносит прибыль, и предложил альтернативу — горизонтальный слой AI Overlay поверх процессов, данных и корпоративных систем.
Saiga Llama 3 8B на 10 ГБ VRAM: как на Habr добились 93% точности по «Войне и миру»
На Habr AI показали, как запустить Saiga Llama 3 8B на 10 ГБ VRAM, сжать два тома «Войны и мира» в саммари и снизить число галлюцинаций жёстким промптом и постобработкой.
4 паттерна нетехнических фаундеров, из-за которых стартап не взлетит
Разработчик с Хабра поработал с несколькими нетехническими фаундерами и описал четыре паттерна, из-за которых стартапы не запускаются — и как AI делает эти паттерны ещё опаснее.
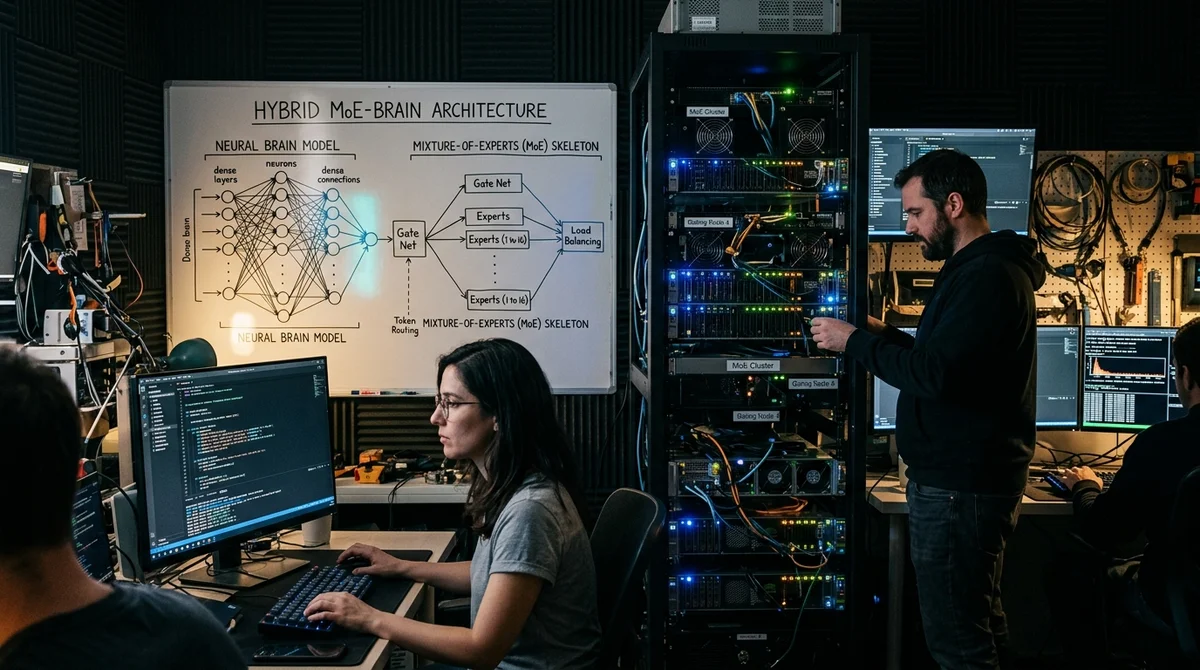
DeepSeek и Gemma: как эксперимент с гибридной LLM на Kaggle сломал библиотеку Transformers
Энтузиасты перенесли четыре 31B-слоя Gemma в MoE-архитектуру DeepSeek без дообучения, обошли ограничения PyTorch и Transformers и запустили хаотичную, но живую LLM-химеру.
Google Gemma 4 и Qwen 3.6 возглавили список лучших локальных моделей для дома в 2026 году
Подборка локальных моделей 2026 года показывает, что для домашнего AI уже хватает RTX 3060, а выбирать нужно по VRAM, квантованию и задаче — от кода до транскрибации.
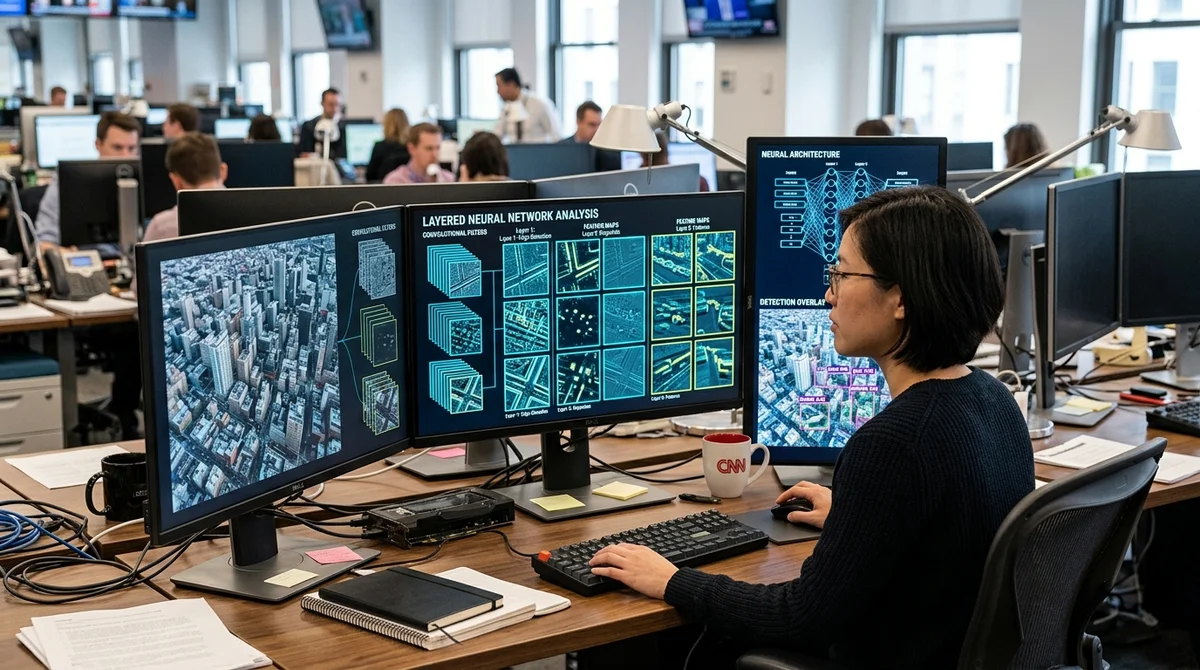
Яндекс Практикум показал, как CNN видят изображения и почему параметры решают не всё
На Habr AI вышел разбор от Яндекс Практикума о том, как свёрточные нейросети обрабатывают изображения, почему архитектура важнее голого размера модели и кому это полезно.
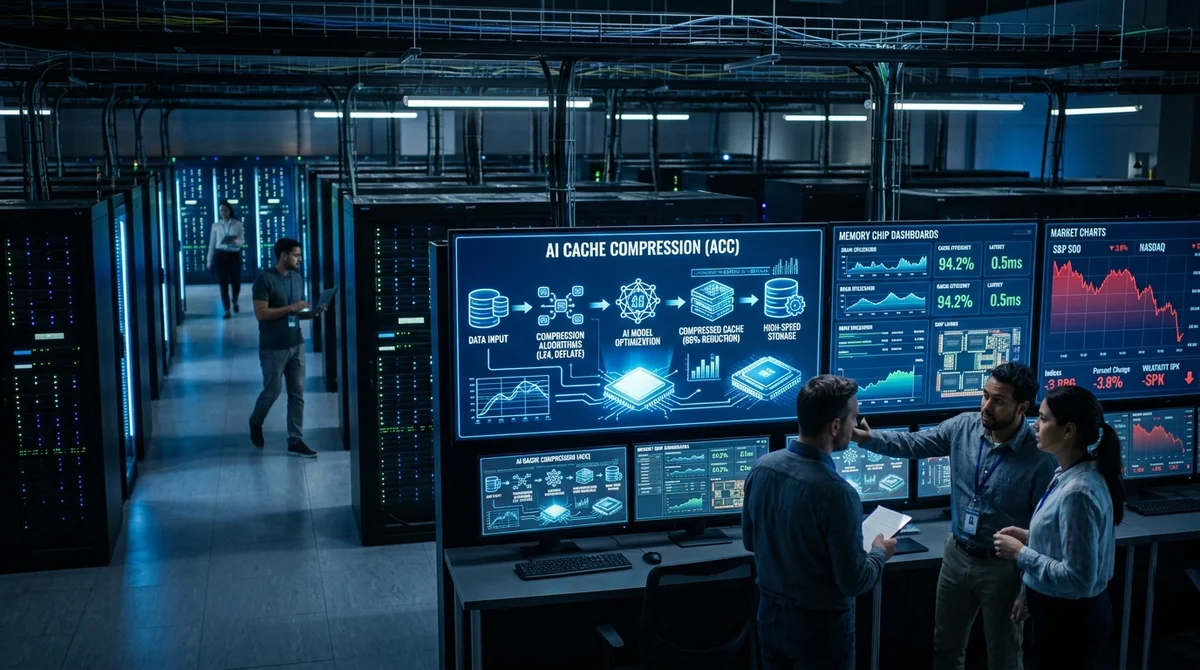
Google показала TurboQuant: 3-битный KV-кэш для LLM, но рынок памяти запаниковал рано
После анонса TurboQuant акции производителей памяти просели, но за громким эффектом скрываются ограничения: кода нет, интеграции нет, а научный спор только разгорается.
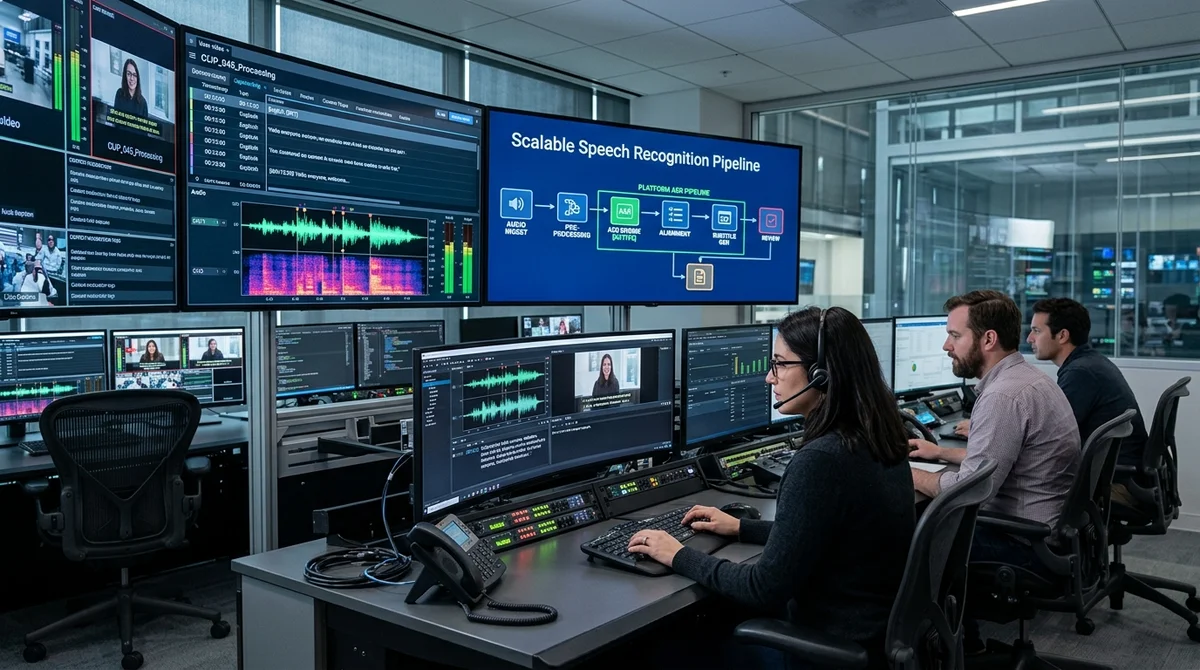
Rutube перешёл от пилота на Whisper к собственной платформе субтитров и распознаванию речи
Rutube рассказал, как превратил быстрый пилот на Whisper в полноценную платформу субтитров с микросервисной архитектурой и собственной ASR, обрабатывающей до 1200 видео в час.
Raft показала, как компаниям оценивать AI-агентов до запуска в рабочих процессах
Raft выпустила практическое руководство по evals для AI-агентов: вместо интуиции и разовых демо компаниям предлагают проверять результат, путь и цену ошибок.
Veai показала, как тестирует ИИ-агента в JetBrains IDE без зависимости от модели
Veai описала подход к UI-автоматизации плагина для JetBrains IDE: команда отделила детерминированный интерфейс от ответов LLM и сократила ложные падения тестов.
Habr AI объяснил, когда бизнесу нужны рекомендательные системы, а когда они лишние
Habr AI выпустил практический гид по рекомендательным системам: когда бизнесу хватит простых правил, в каких случаях нужны ML-модели и какие метрики решают, окупится ли внедрение.
Для Telegram выпустили антиспам-бота Tab на собственной нейросети с дообучением
Разработчик представил бесплатного антиспам-бота Tab для Telegram: он фильтрует сообщения собственной нейросетью, дообучается на жалобах модераторов и уже работает в реальных чатах.
SpeShu.AI запустила AI-Профи — сервис для подбора AI-специалистов под задачи бизнеса
SpeShu.AI представила сервис AI-Профи: компании могут за несколько кликов найти AI-специалистов под конкретные задачи на фоне резкого роста спроса на нейросетевые навыки в России.
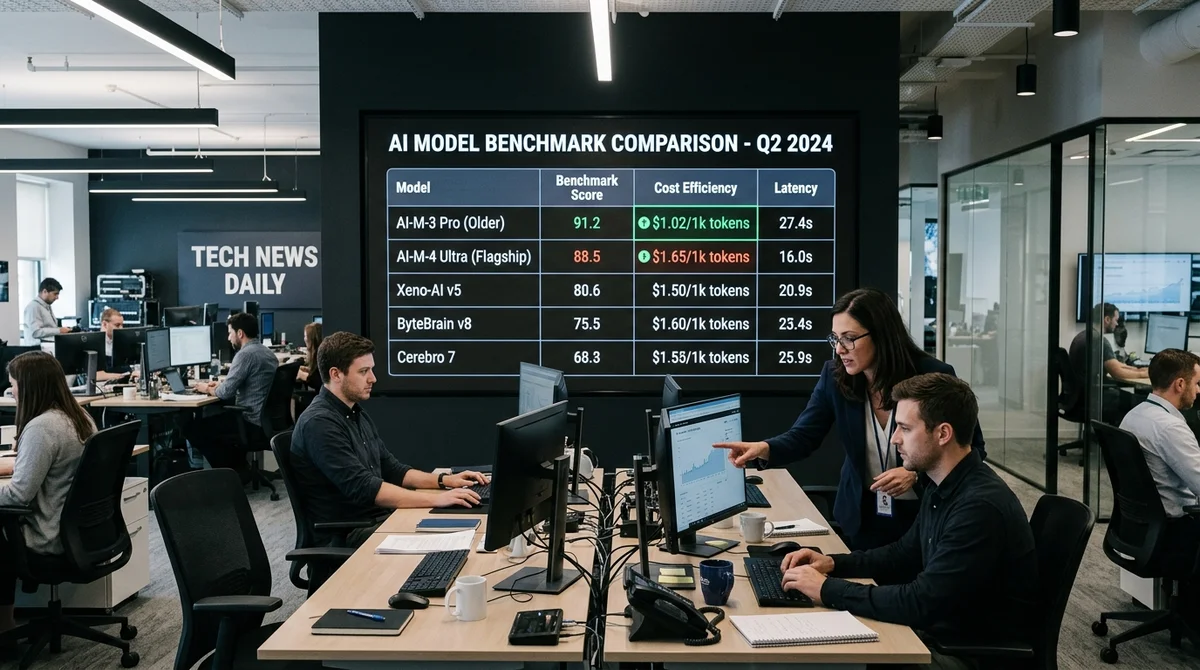
Qwen 3.6 Plus обошёл DeepSeek V4 Pro в русском battle test и оказался выгоднее
В свежем сравнении шести апрельских LLM модель Qwen 3.6 Plus набрала 92 балла на русском контенте и обошла новый DeepSeek V4 Pro, который оказался слабее и заметно дороже.
Сбер выпустил Kandinsky 6.0 Image Pro — единую модель для генерации и редактирования изображений
Сбер представил Kandinsky 6.0 Image Pro — модель для генерации и редактирования изображений, ускоренную более чем на 40% и дополненную Image RAG для культурного контекста.
NASA и SETI описали базовые модели для астробиологии и поиска внеземной жизни
Группа авторов из NASA и SETI предложила мультимодальную базовую модель для астробиологии — от поиска биосигнатур до планирования автономных космических миссий.
Как Cursor за три дня и $180 создал прототип, который расколол команду разработки
В крупной ИТ-компании архитектор за три дня и $180 в Cursor собрал рабочий прототип, а команда за три месяца — более надежный модуль, который бизнесу оказался менее заметен.