Habr AI
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации
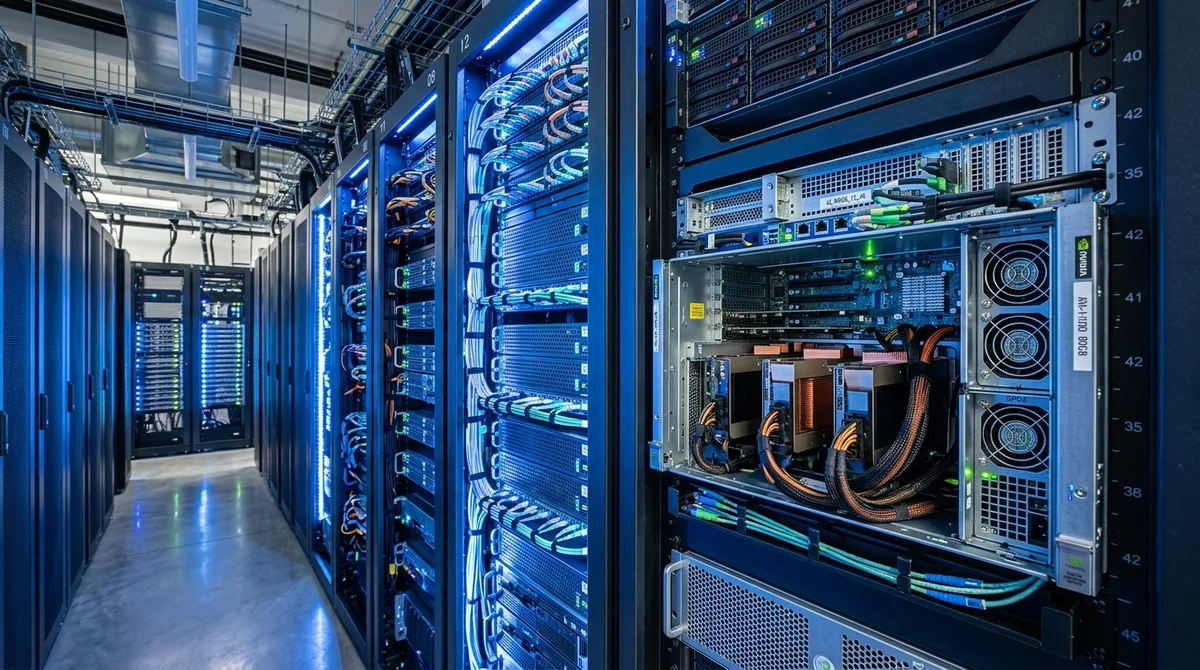
Т1 Облако: H200 и L40S — технический обзор GPU для задач генеративного ИИ
Т1 Облако опубликовало технический обзор GPU-серверов H200 и L40S с фотографиями из ЦОДа и объяснило, как правильно выбирать ускоритель под задачи ИИ.
NVIDIA Nemotron 3 Super 120B: тест на реальных аналитических задачах на одной GPU
Команда Luxms BI неделю тестировала NVIDIA Nemotron 3 Super 120B на реальных задачах корпоративной аналитики — 120B параметров и 256K токенов контекста в одной видеокарте.
Международный бестселлер о больших языковых моделях вышел на русском языке
Издательство БХВ выпустило перевод международного бестселлера о LLM — практическое руководство для разработчиков, которым нужно понять устройство языковых моделей и применять их в реальных проектах.
ПСБ показал, как внедряет ИИ в банке: чат-боты, RAG и сервисы для бизнеса
ПСБ раскрыл, как использует генеративный ИИ для МСБ и сотрудников: через ассистента «Катюша», RAG-консультации, платежи в мессенджерах и внутренние пилоты для продаж.
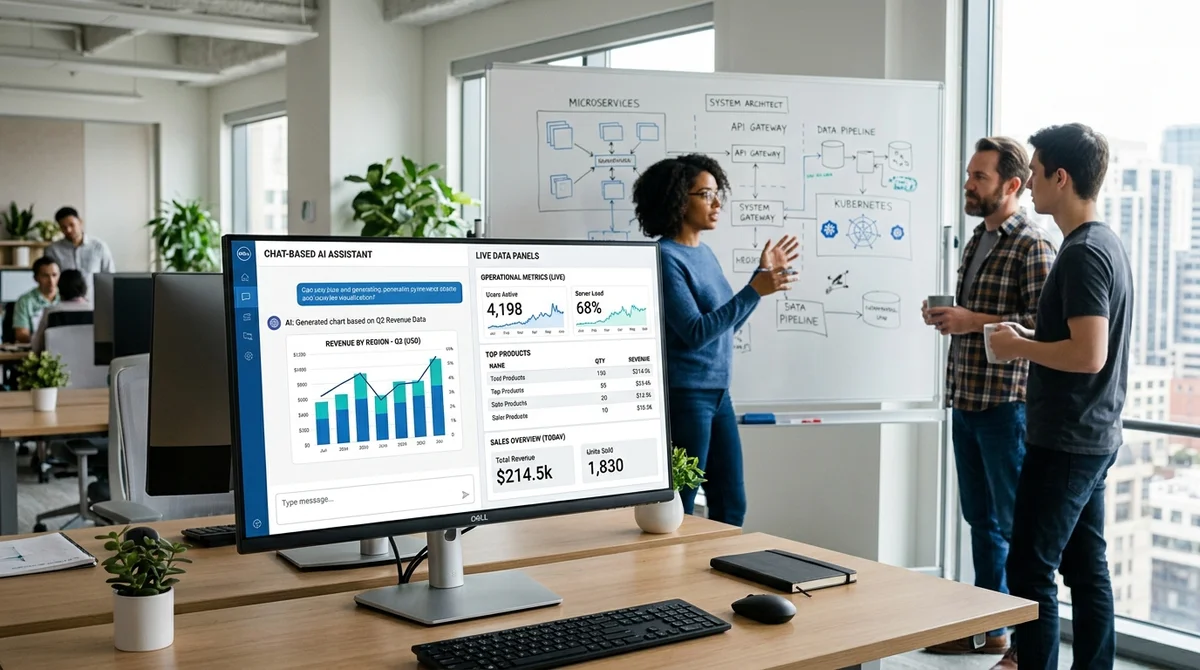
Yandex Cloud объяснила, почему интеграцию нейросетей в DataLens на старте ведёт фронтенд
Команда Yandex Cloud показала на примере DataLens, как вынести первый слой интеграции ИИ в BFF фронтенда, чтобы быстрее запускать чат-ассистента и управлять контекстом ближе к интерфейсу.
Claude Code на Windows: как настроить стабильную и быструю рабочую среду
Инженер из AWS-команды с 150+ аккаунтами описал, как довести Claude Code на Windows до стабильной и быстрой работы без перехода на Linux, с упором на актуальные настройки апреля 2026.
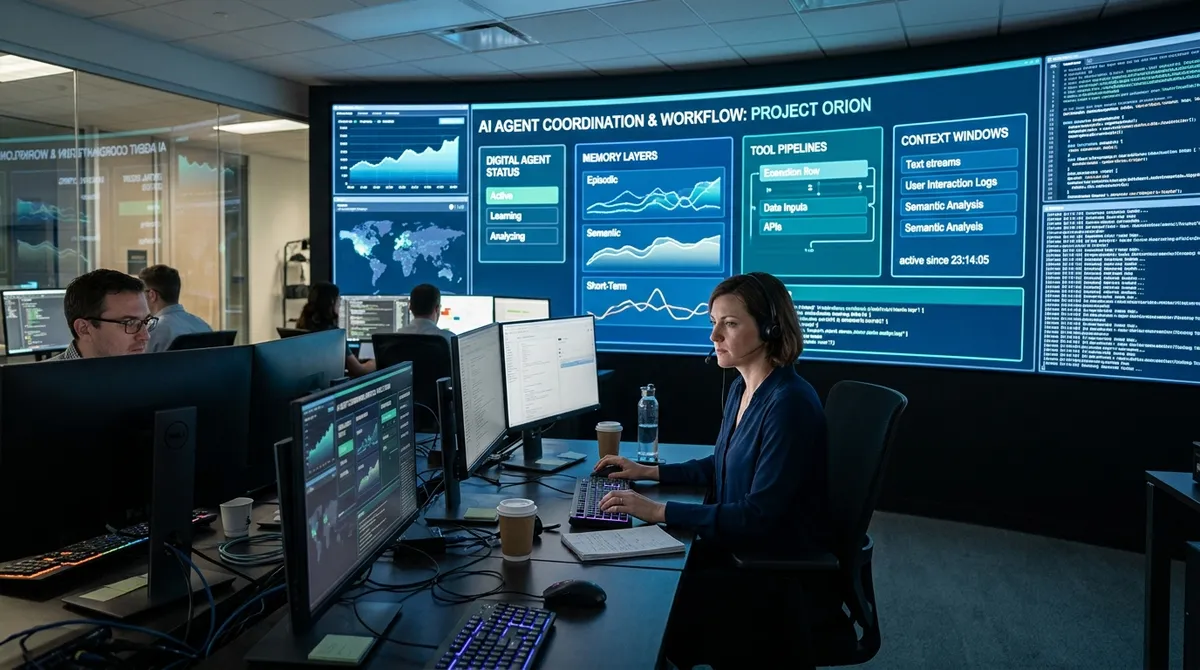
Anthropic, OpenAI и LangChain объяснили, зачем ИИ-агентам нужен harness
Anthropic, OpenAI и LangChain смещают фокус с самих моделей на agent harness — слой оркестрации, памяти и инструментов, который делает ИИ-агентов устойчивыми в продакшене.
Anthropic и другие языковые модели могут вызывать скрытые инструменты без разрешения
Исследователь описал сбой, при котором Anthropic, Gemini и Grok могут вызвать неразрешённый инструмент, если функция существует в окружении, а проверка имени на стороне API или клиента слабая.
Финтех-группа «Свой» объяснила, как сделать LLM-агентов дешевле и точнее в коде
Команда финтех-группы «Свой» выпустила практический гайд о том, как превратить LLM из «улучшенного поиска» в управляемого агента, снизить расходы на токены и повысить точность генерации кода.
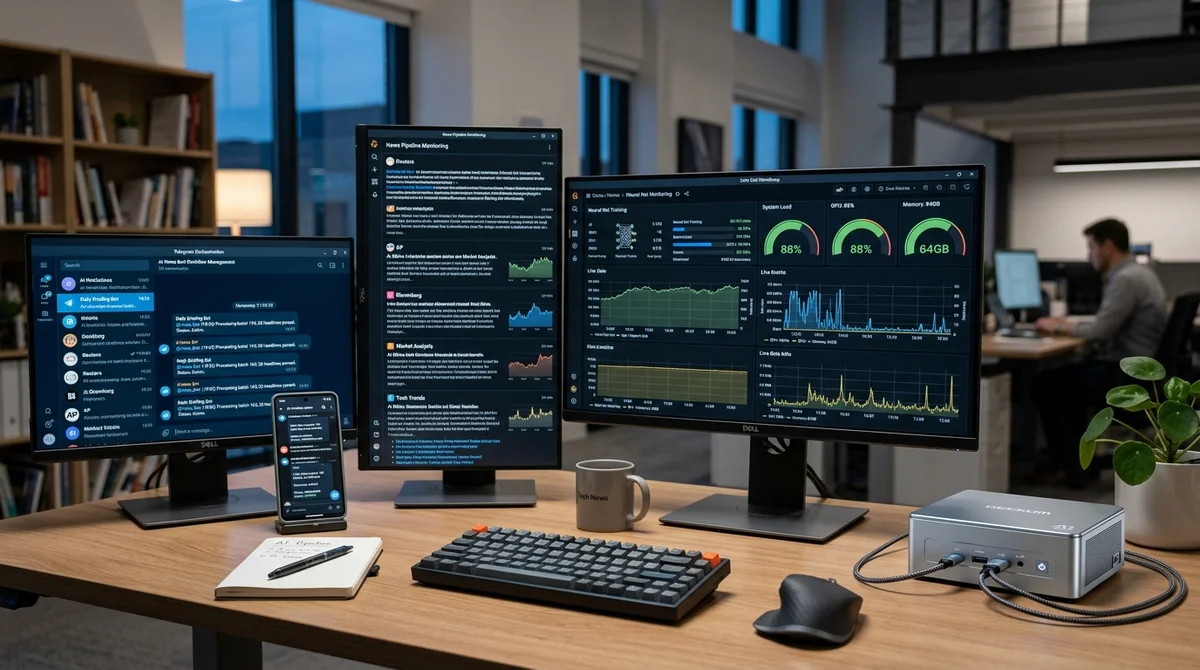
Как автор Habr превратил семь сценариев n8n в автономную AI-новостную систему
Автор за полтора месяца превратил хрупкий набор из семи сценариев n8n в единый Python-пайплайн с 11 воркерами, 5 AI-агентами, локальной LLM и управлением через Telegram.
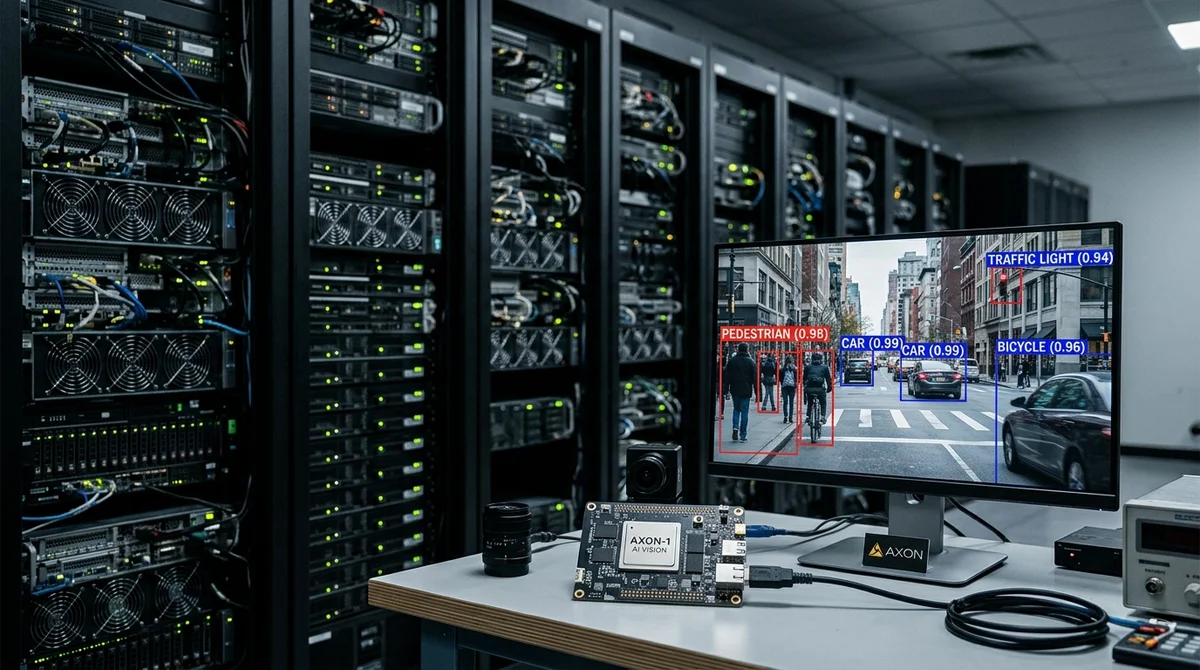
TAPe довела детекцию на COCO до уровня RF-DETR и YOLO с моделью менее 100 тысяч параметров
Авторы TAPe заявили, что довели детекцию на COCO до уровня сильных RF-DETR и YOLO, сохранив менее 100 тысяч параметров, 7–8 мс на кадр и заметно снизив требования к данным и железу.
Почему OpenCode и сильные модели пишут зелёные, но бесполезные тесты — и как это чинить
Свежая модель и мощный агент вроде OpenCode не спасают, если кодовая база забита any, а команда просит AI просто написать тесты без спецификации, ограничений и проверки.
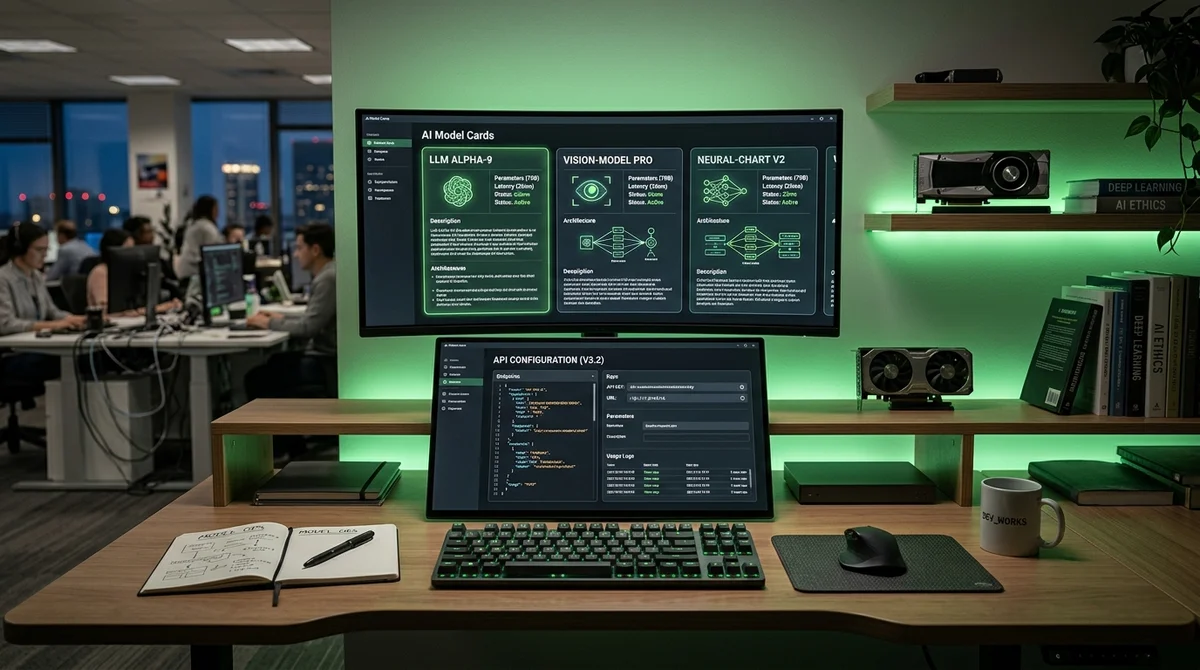
NVIDIA открыла бесплатный API к 100+ ИИ-моделям с OpenAI-совместимым доступом
NVIDIA начала выдавать бесплатные ключи к более чем 100 ИИ-моделям: разработчики получают OpenAI-совместимый API, лимит 40 запросов в минуту и доступ без банковской карты.
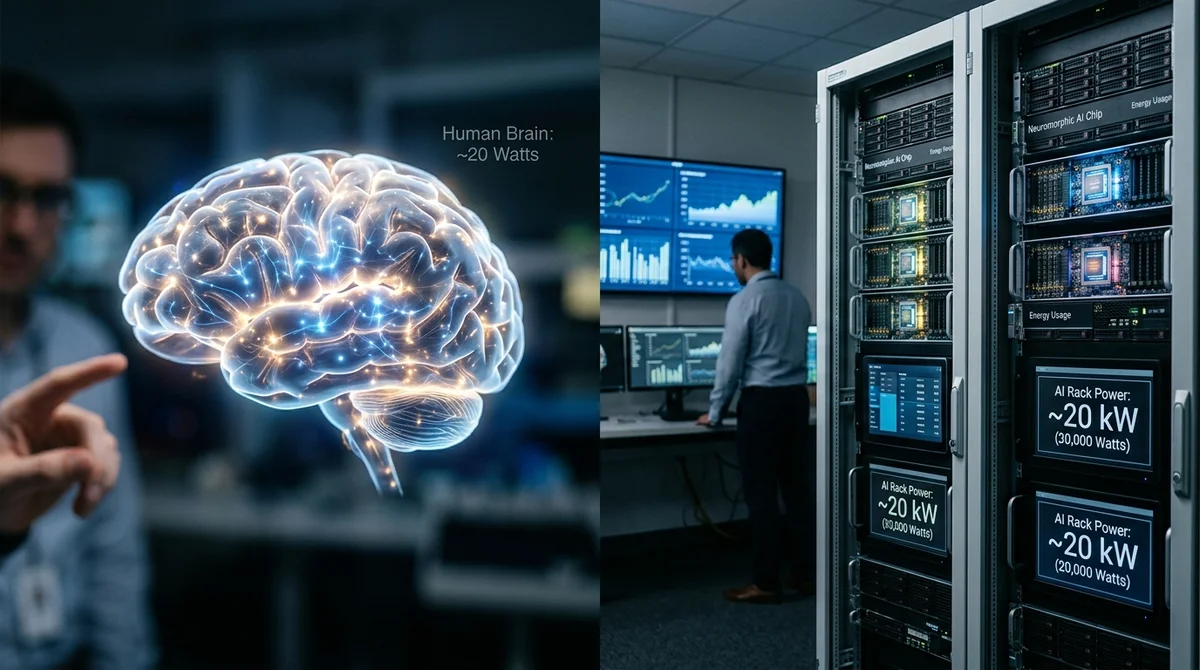
Почему мозг в сотни миллионов раз эффективнее GPT-4 и куда идут нейроморфные чипы
Автор разбирает, почему человеческий мозг тратит на когнитивные задачи на порядки меньше энергии, чем GPT-4, и как нейроморфные чипы пытаются сократить этот разрыв.
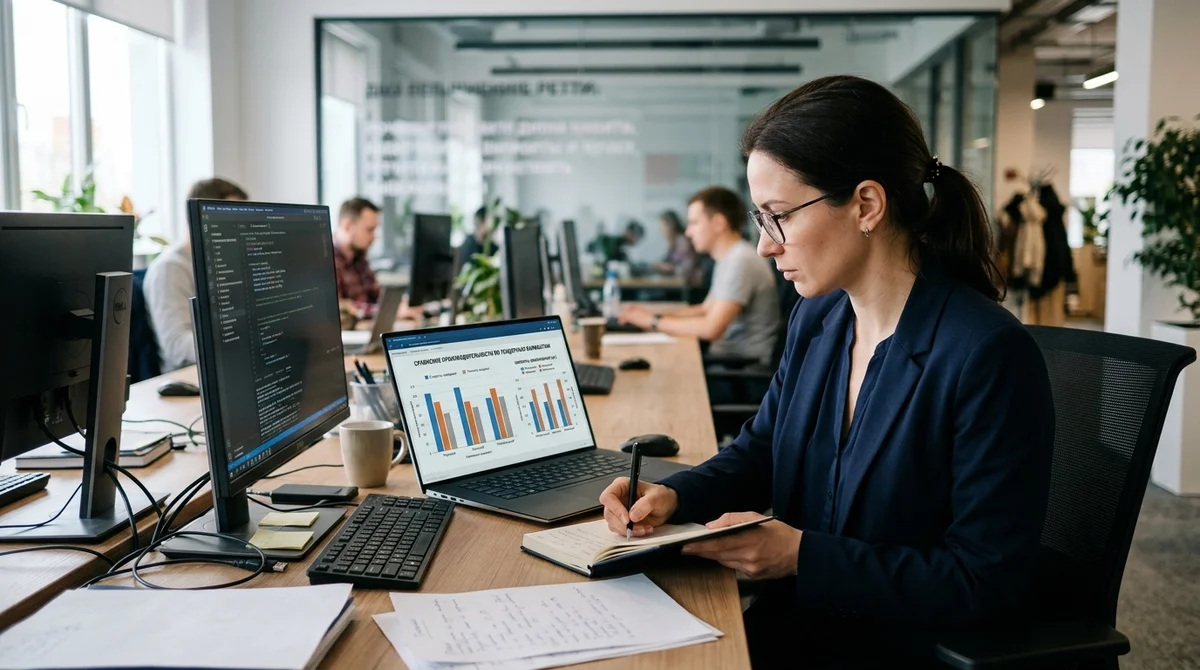
Исследование о ChatGPT: влияет ли женская форма промпта на качество решения задач
Авторский эксперимент на LiveCodeBench показал, что в GPT-5.4 mini женская самопрезентация в русском промпте немного снижает pass@1, особенно на сложных задачах.
RuStore внедрил AI в ИБ: как VK автоматизирует ревью задач, кода и DAST-проверки
Команда ИБ RuStore использует AI для первичного разбора security-задач, проверки merge request и динамического тестирования, чтобы снять рутину с инженеров и ускорить релизный цикл.
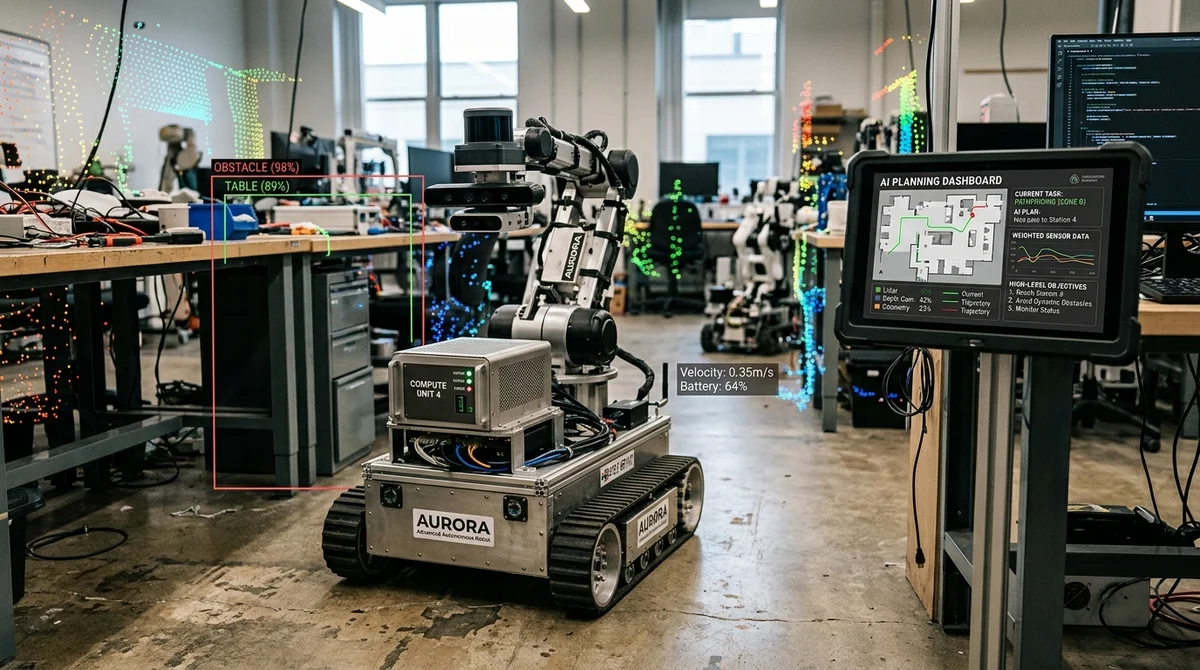
OpenGrall представил архитектуру для роботов с ИИ, где языковая модель отвечает за стратегию
Фреймворк OpenGrall предлагает разделить мышление и управление: LLM отвечает за стратегию, а TinyML — за исполнение и безопасность, снижая задержки даже на слабом железе.
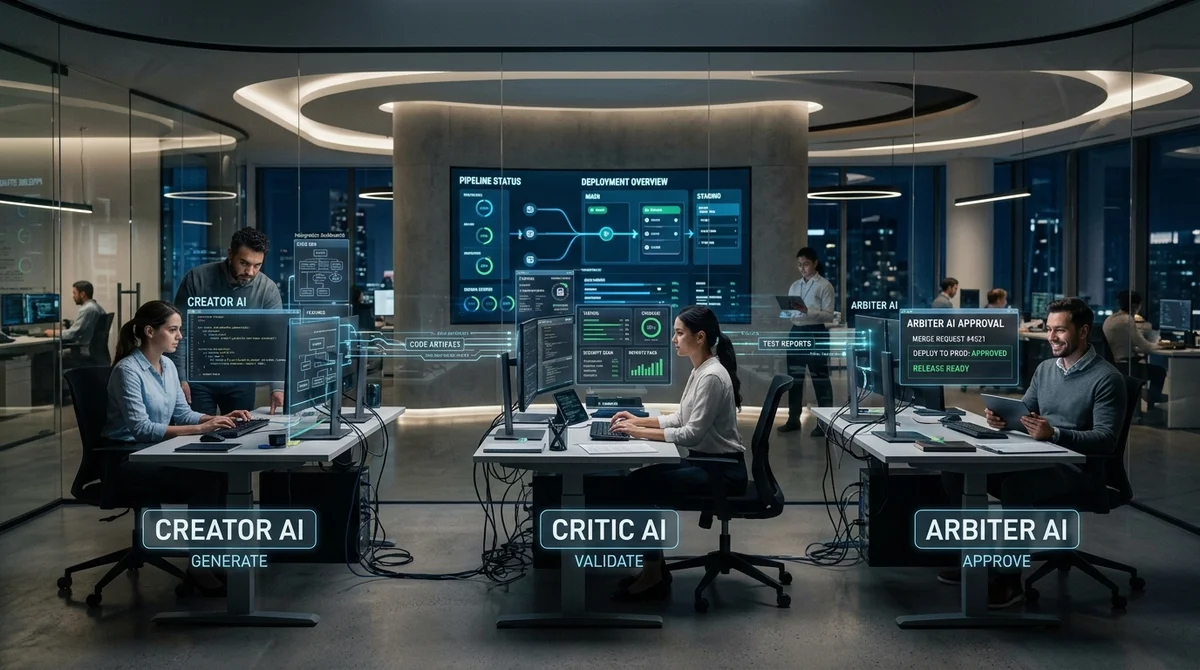
Habr AI: как Pipeline Triad собирает конвейер ИИ-агентов вместо команды разработки
На Habr AI разобрали Pipeline Triad — модель, в которой этапы разработки проходят через тройки ИИ-агентов, а человек подключается только в четырех контрольных точках.
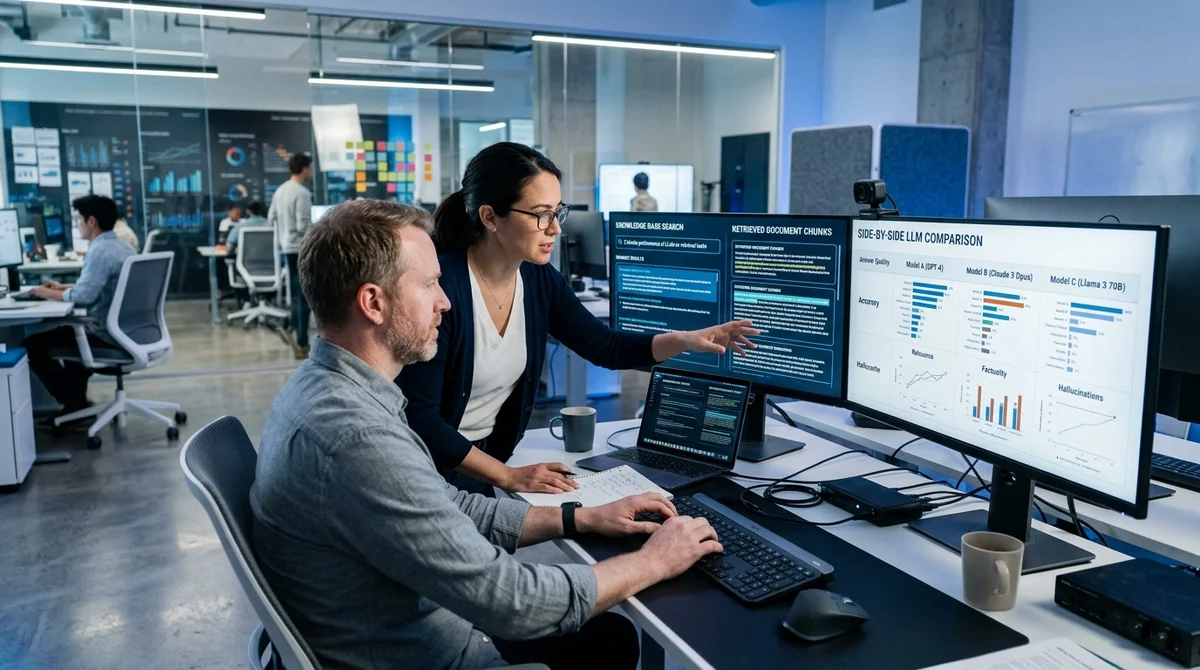
Gramax показала, как сравнивать качество ответов RAG без ручной оценки «на глаз»
Gramax описала, почему retrieval-метрики недостаточны для RAG, и предложила оценивать не найденные чанки, а итоговый ответ пользователя — по полноте, точности и устойчивости.
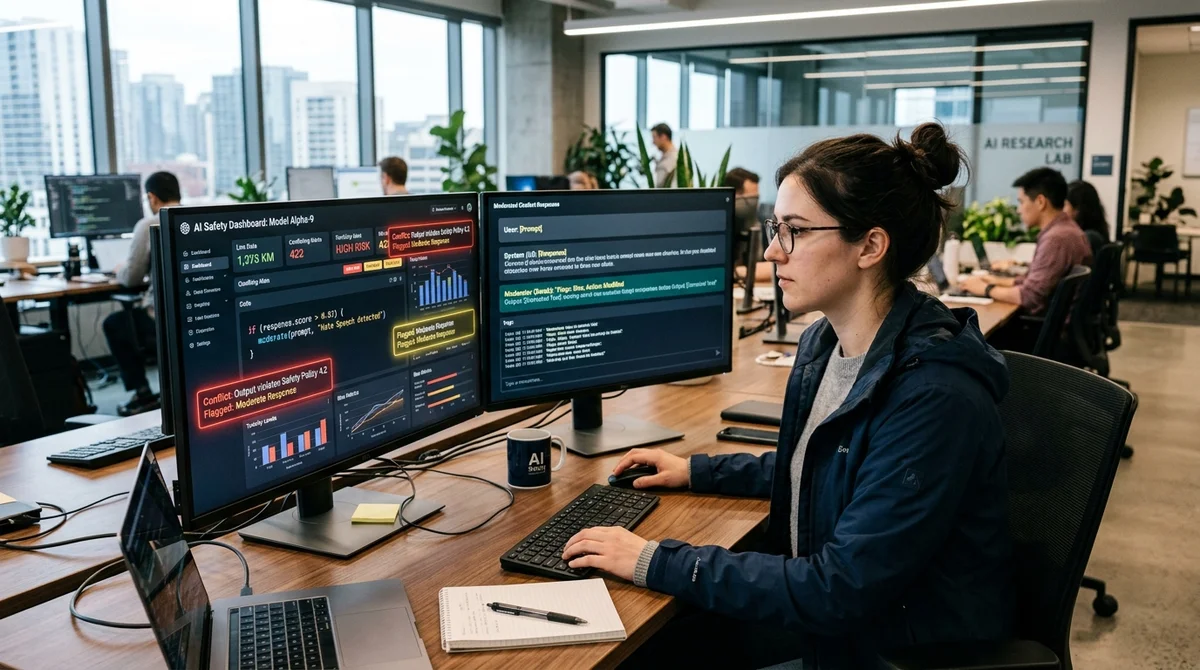
Java-разработчикам показали, как guardrails для LLM блокируют инъекции и токсичные ответы
Разбор о том, почему одного system prompt недостаточно для защиты LLM, и как guardrails в Java перехватывают опасные входы и фильтруют токсичный или нежелательный вывод модели.
Anthropic и модель Mythos: почему опасность для банков быстро стала риском для всех
Anthropic показала Mythos как слишком опасную для открытого доступа модель, но главный риск оказался не в банках, а в том, что малый бизнес не успевает закрывать уязвимости до атак.
Anthropic и Claude Mythos: почему критики называют запуск модели дорогим PR-спектаклем
Критическая колонка о Claude Mythos утверждает, что Anthropic продаёт не только ИИ-модель, но и миф о её почти человеческой природе, усиливая дефицит и спрос среди корпораций.
ИИ-ассистенты в 2026 году: как соло-разработчик стал быстрее команды из трёх человек
Автор показывает, что в 2026 году один разработчик с набором open-source ИИ-инструментов может писать, тестировать и коммитить код быстрее, чем небольшая команда двумя годами раньше.
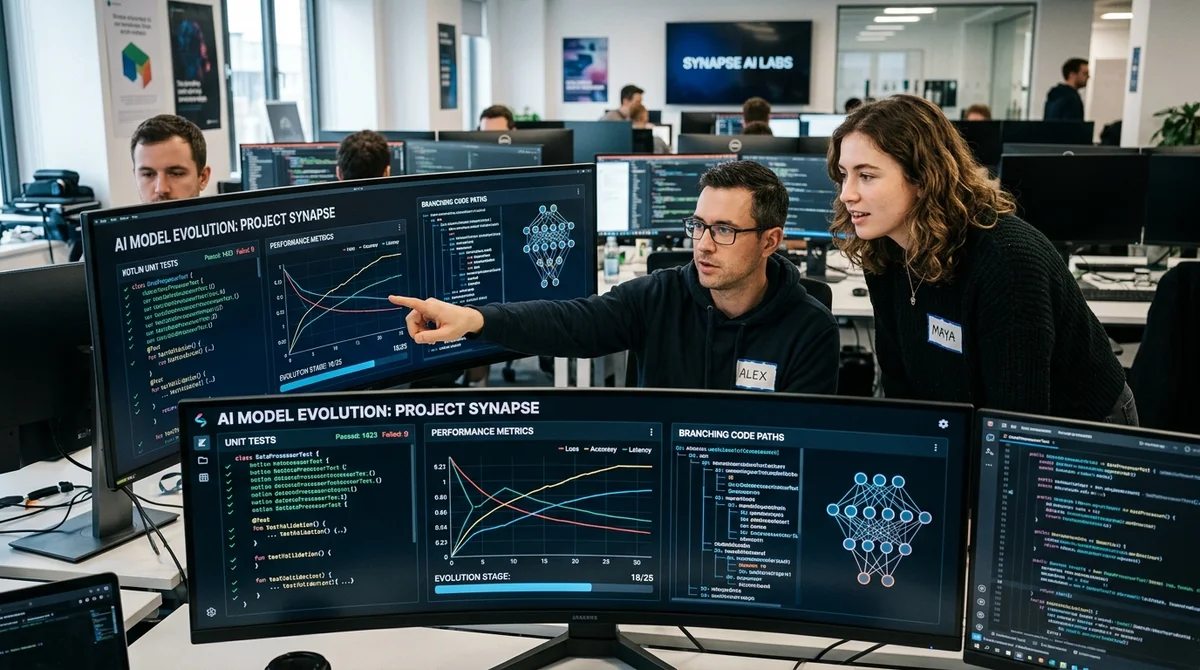
ecom.tech сравнила эволюционное дообучение Qwen3-4B с SFT и GRPO для тестов на Kotlin
Команда ecom.tech дообучила Qwen3-4B-Instruct для генерации unit-тестов на Kotlin и показала, что эволюционный алгоритм обходит SFT и GRPO по метрикам качества, но ухудшает общие способности модели.
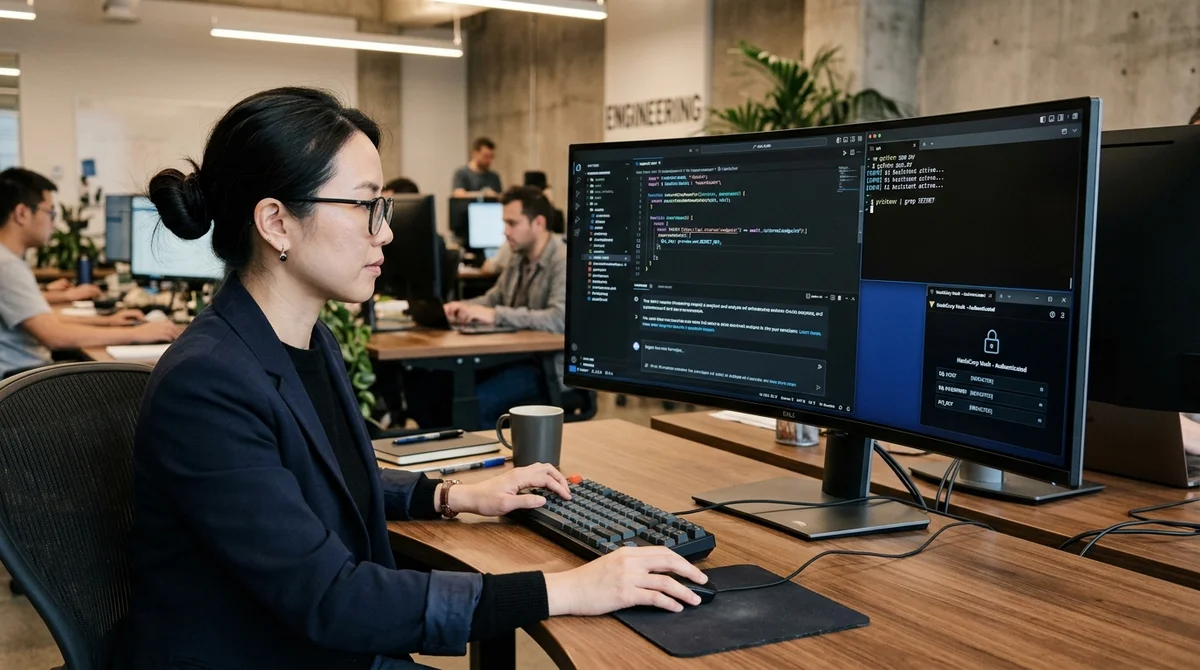
Yandex Code Assistant проверили на задаче с секретами и сравнили по опыту с Cursor
Инженер «Инфосистем Джет» протестировал Yandex Code Assistant на задаче с хранением секретов и показал, что агент уже близок к Cursor, но всё ещё требует контроля со стороны разработчика.
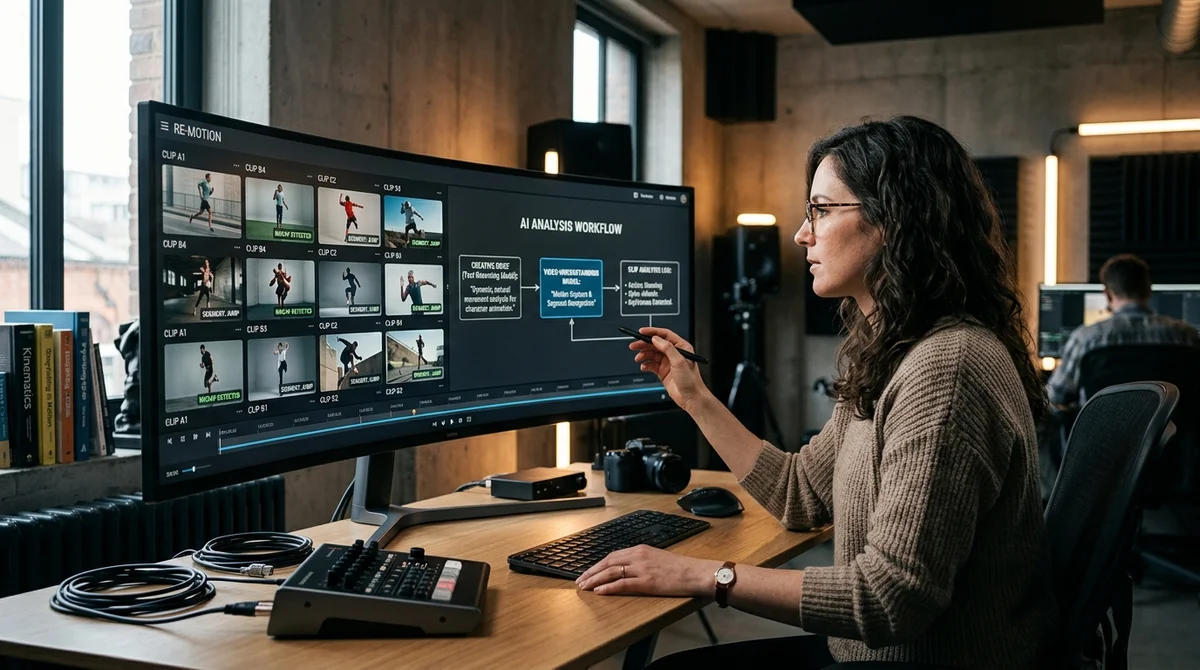
Claude и Qwen Omni: как разработчик подключил видеоанализ к рабочему пайплайну
Автор публикации на Habr связал Claude с Qwen Omni, чтобы обойти отсутствие прямой работы с видео и автоматически разобрать 29 анимационных референсов по движениям и категориям.
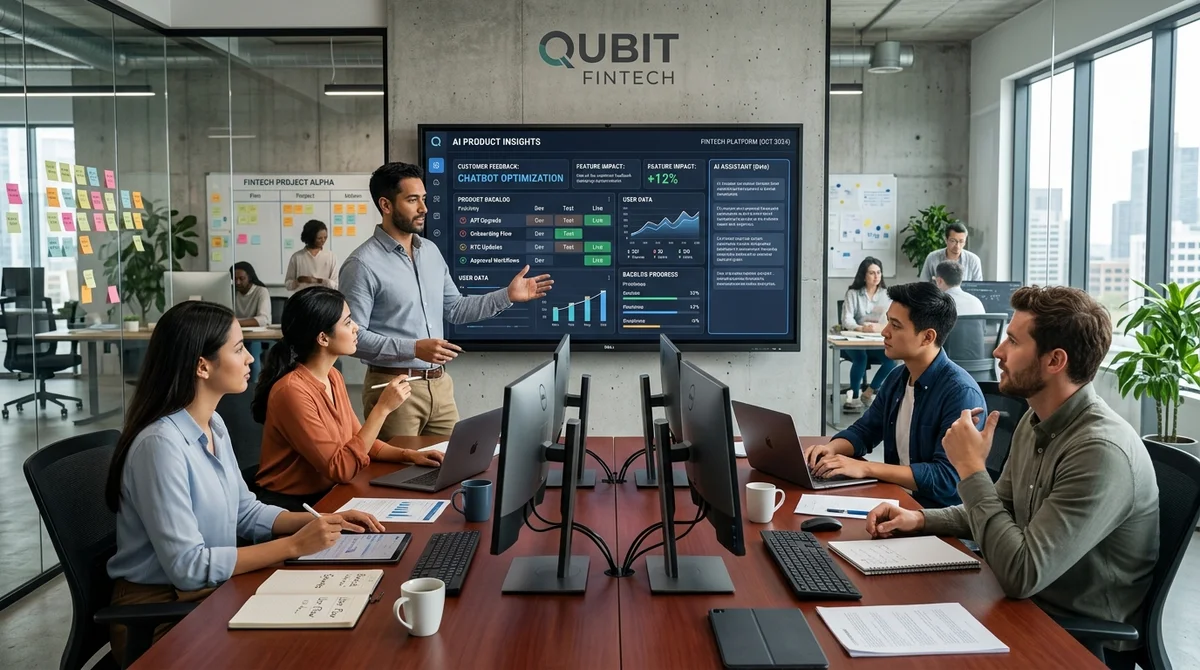
Как Совкомбанк сократил рутину продуктовой команды на 50% с помощью ИИ-ассистента
В Совкомбанке собрали ИИ-ассистента на базе LLM и единого промпта, чтобы забрать у продакт-менеджеров документацию, согласования и часть аналитики, освободив до половины времени.
Критики назвали партнёрство OpenAI с McKinsey и Accenture ставкой на AI-хайп
Автор жёсткой колонки утверждает, что программа OpenAI Frontier Alliances продаёт бизнесу не готовый результат, а дорогой процесс внедрения AI coworkers через крупных консультантов.
Google Veo, Runway и Kling вошли в топ бесплатных нейросетей для генерации видео в 2026 году
Авторы сравнили десять популярных бесплатных генераторов видео, включая Google Veo, Runway и Kling, и проверили их на сложной сцене с енотом, шерстью, стеклом и светом.
Rufler упрощает рои в Claude Code: один конфиг вместо ручной оркестрации агентов
Open-source инструмент Rufler сводит запуск автономных агентов в Claude Code к одному конфигу, автоматически собирает роли, задачи и MCP-серверы и упрощает контроль токенов и статусов.