Habr AI
Источник AI-новостей. Материалы автоматически отбираются и адаптируются редакцией Hamidun News.
Последние публикации
Claude Code помог собрать приложение для анализа графов почти за час — кейс разработчика
Разработчик с низкими ожиданиями собрал рабочее приложение для анализа графов примерно за час, но потом потратил ещё три недели на тесты, документацию и приведение процесса в порядок.
IBS объясняет, как нейросети меняют проектирование ПО и почему не заменят архитектора
IBS разбирает, как большие языковые модели и генеративные инструменты помогают проектировать системы, сравнивать компромиссы и ускорять работу архитектора, но не снимают с него ответственность.
Playwright и MCP: как AI-агент проверяет UI и базу данных без ручных SQL-ассертов
Playwright-агент в связке с MCP может не только прогнать checkout в браузере, но и сразу подтвердить изменения в базе данных без ручных SQL-ассертов и лишнего тестового кода.
Почему модели OpenAI, Google и Anthropic становятся убедительнее, но ошибаются чаще
Крупные ИИ-лаборатории пытаются лечить ошибки моделей дополнительными вычислениями, но чем убедительнее становятся ответы, тем труднее заметить глубокие галлюцинации.
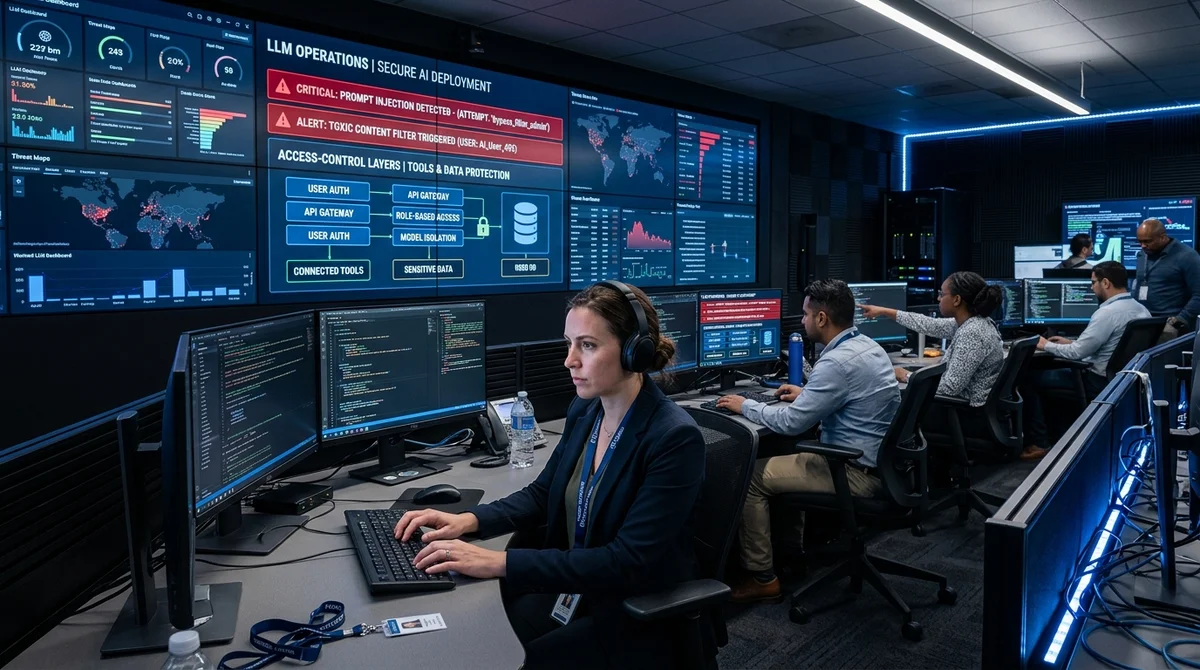
Habr AI: зачем языковым моделям guardrails и как защищаться от промпт-хакинга
Habr AI разбирает, почему для LLM уже нужен отдельный защитный слой: от токсичного контента и утечек данных до prompt injection, jailbreak-атак и контроля работы агентов.
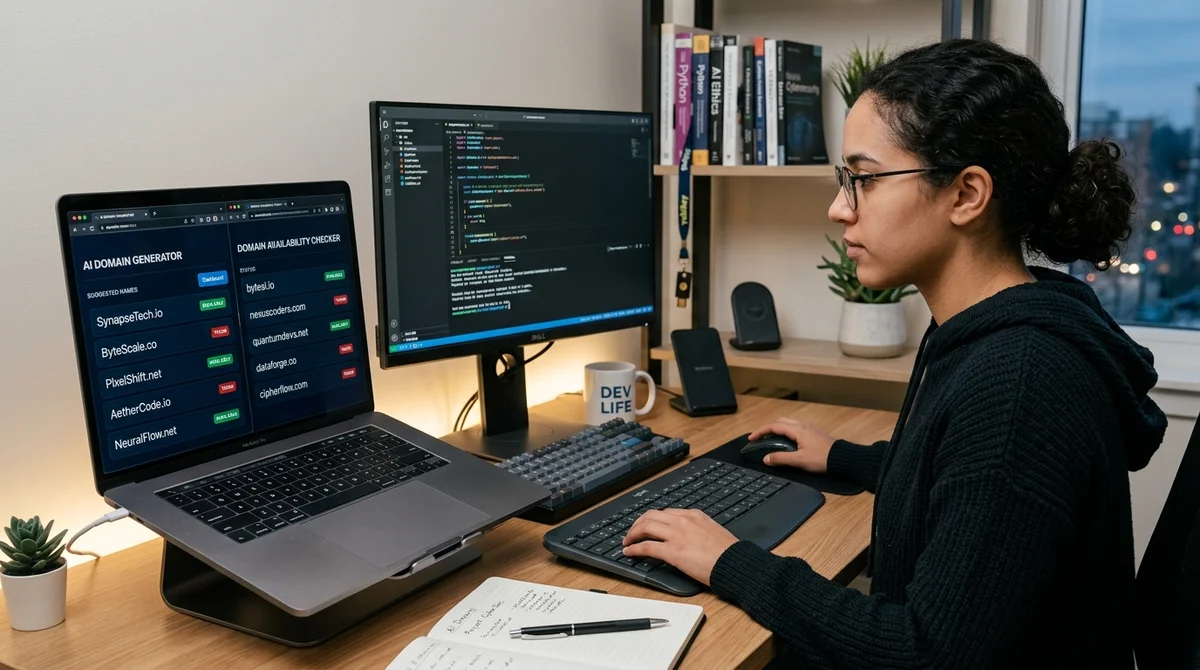
Инженер Selectel показал LLM-агента для автоматического подбора свободных доменов
Инженер Selectel собрал Python-сервис, который просит LLM генерировать доменные имена и сразу проверяет их через WHOIS, оставляя только свободные варианты.
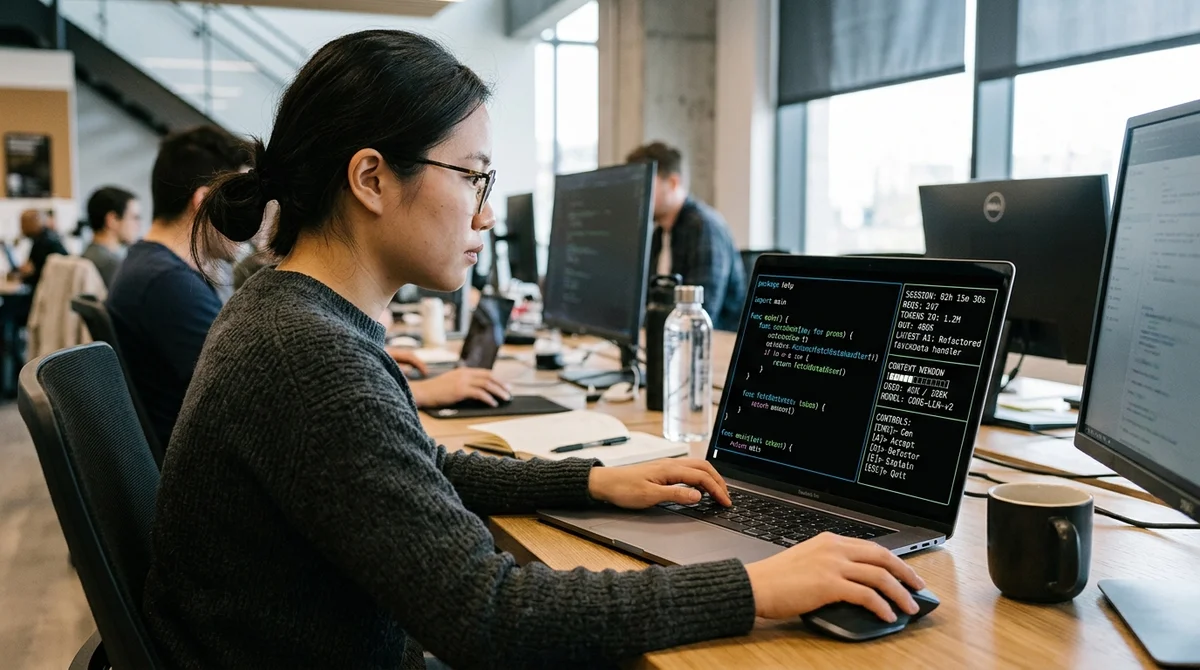
Anthropic объяснила, как и когда в Claude Code правильно начинать новую сессию
Anthropic выпустила команду /usage и объяснила, как в Claude Code управлять сессиями, чтобы миллион токенов контекста не превращался в шум и не ухудшал качество ответов.
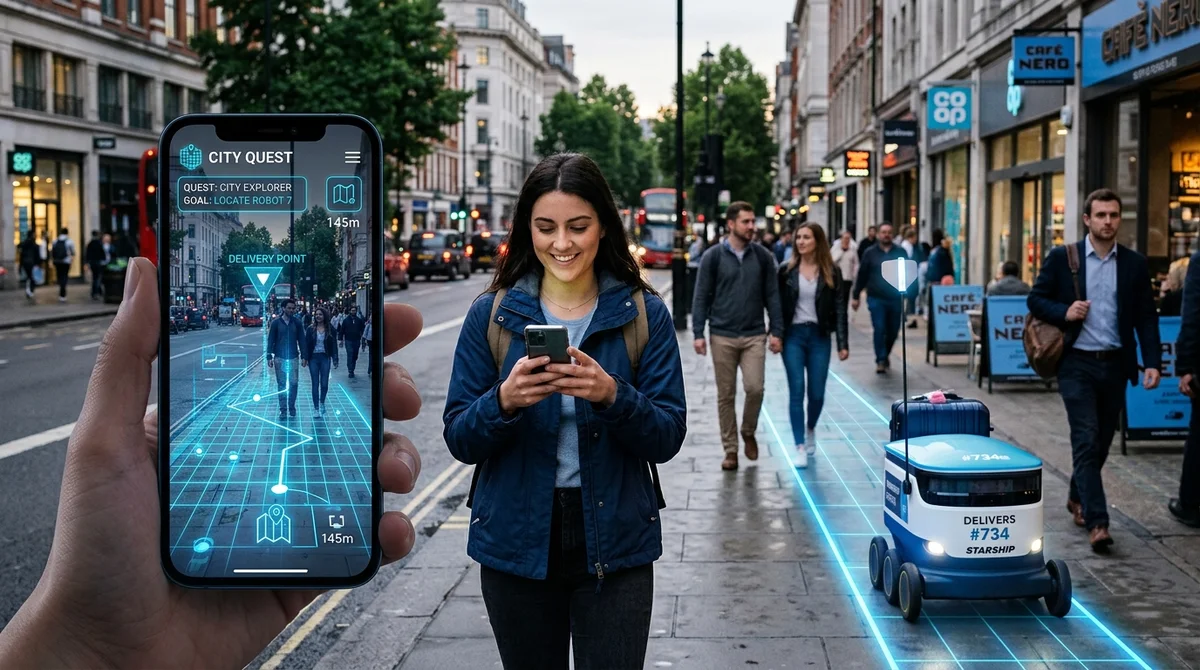
Niantic показала, как Pokémon Go превращает действия игроков в датасеты для ИИ
Niantic, Google и другие компании все чаще превращают обычные действия пользователей — от игры и поездок до капчи — в данные для обучения ИИ, навигации и роботов.
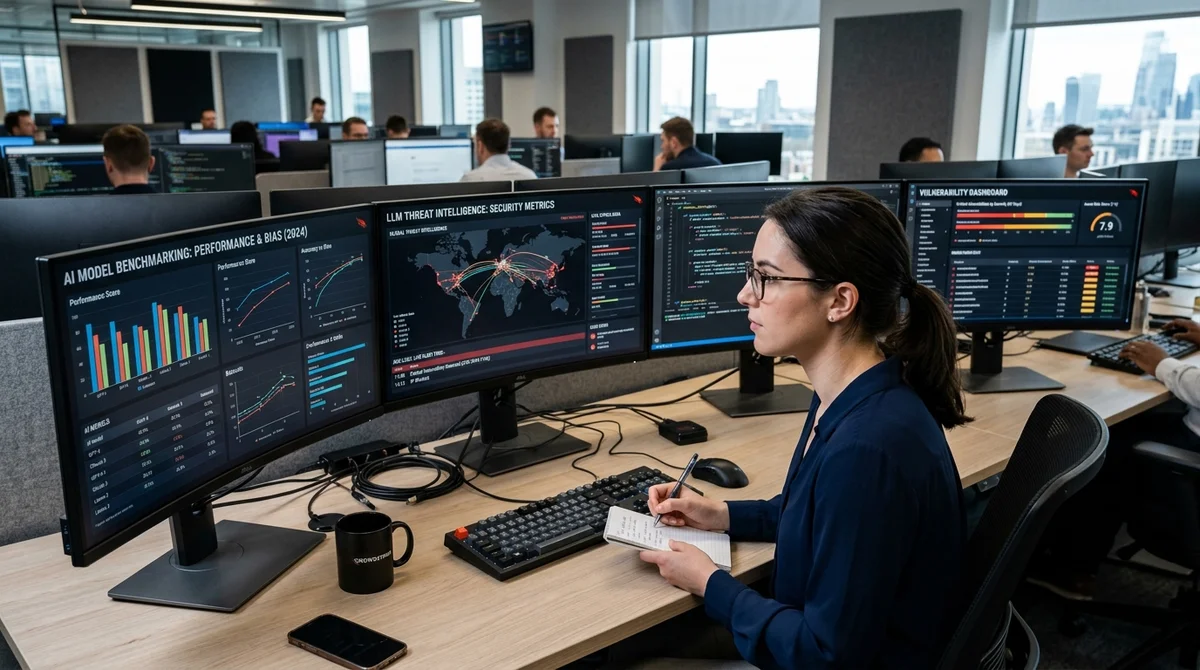
Positive Technologies перечислила лучшие бенчмарки для оценки LLM в кибербезопасности
Positive Technologies разделила кибербенчмарки для LLM на тесты знаний и практики и показала, что модели уже сильнее людей в теории, но все еще заметно проседают в реальных задачах.
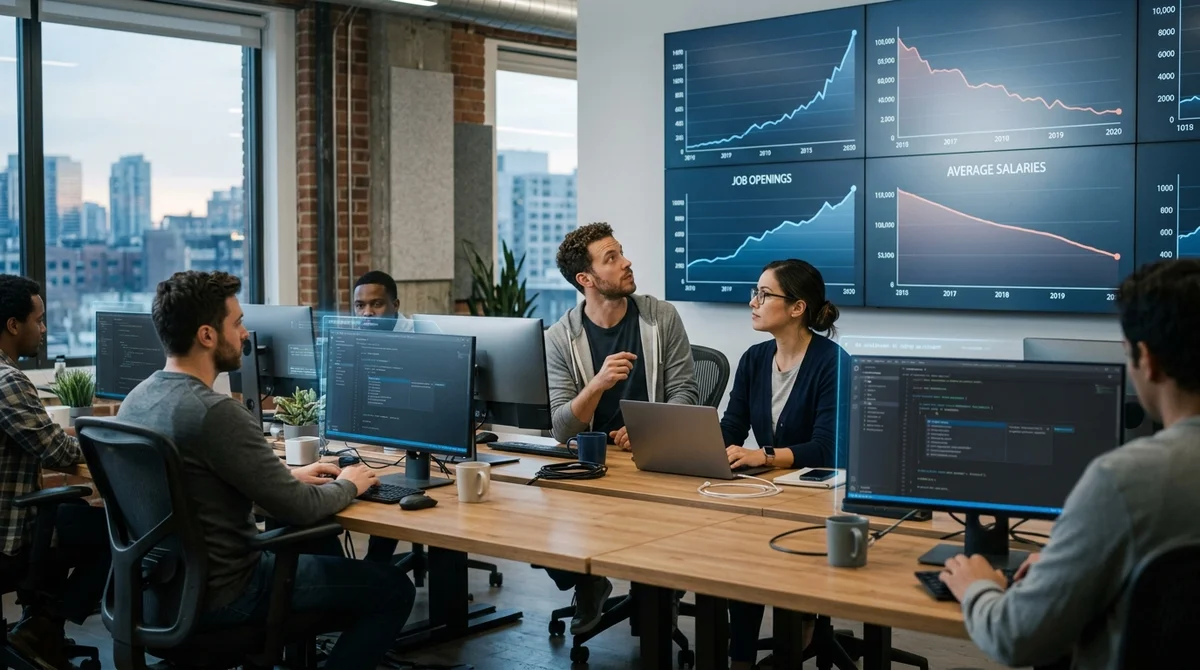
ИИ-дефляция в IT: кейсы Klarna и IBM объясняют, почему вакансий больше, а рост зарплат слабее
В разработке возник новый парадокс: вакансий для инженеров стало на 11% больше, но рост зарплат в IT замедлился до 1,6%, а у части сеньоров доходы уже ушли в минус.
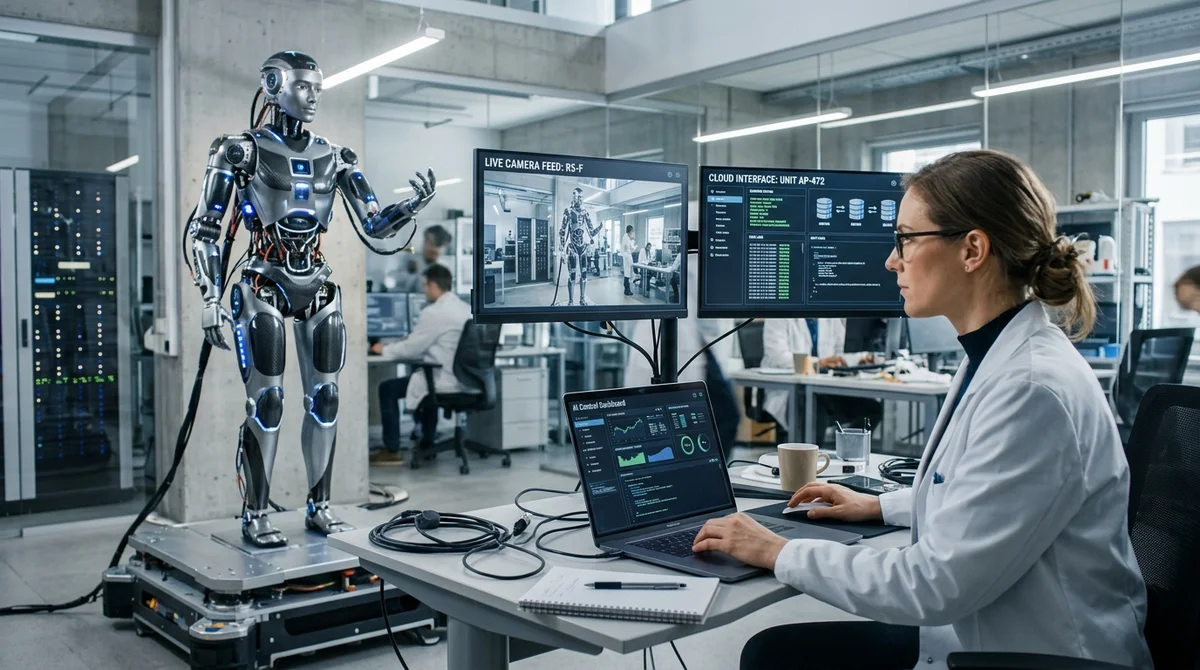
МТС показала, как OpenClaw подключили к роботу и вынесли AI-агента в физический мир
Команда MWS показала, что OpenClaw можно связать с физическим роботом через простую программную прослойку и облачную LLM, не строя сложную VLA-систему с нуля.
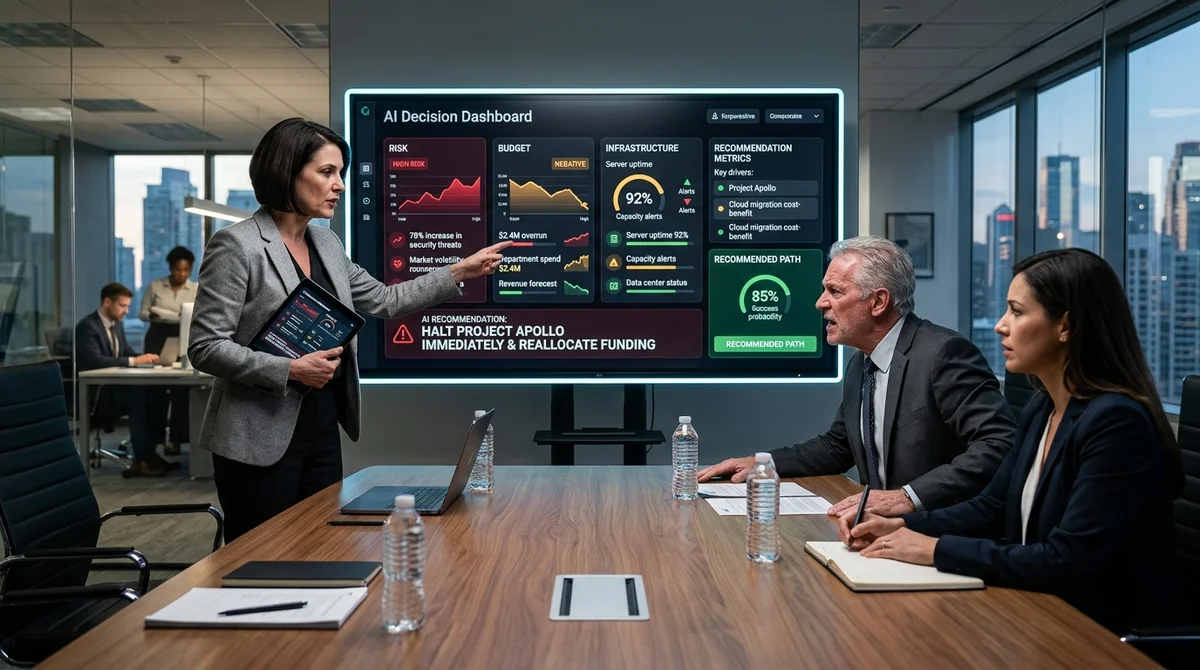
Claude Sonnet помог топ-менеджерам за 8 часов собрать ИИ-директора для жёстких решений
На закрытом хакатоне Snow BASE команда из CEO, CTO и CIO за восемь часов собрала CAITO — ИИ-директора на Claude Sonnet, который меняет позицию только при появлении новых фактов.
Почему ServiceNow, Atlassian и BMC меняют рынок ITSM и спор о платформе в 2026-м
Рынок ITSM с ИИ смещается от чат-ботов к управляемой инфраструктуре, где выбор между коробкой и платформой определяют безопасность, масштаб и контроль над агентами.
ServiceNow и Atlassian ведут рынок ITSM к AI-платформам вместо коробочных решений
AI в ITSM быстро смещается от чат-ботов к управляемой инфраструктуре: рынок сравнивает платформенный и коробочный подходы, а ключевыми становятся аудит, безопасность и гибкость.
Wildberries & Russ описала, какой уровень зрелости данных нужен для точных ИИ-агентов
Wildberries & Russ описала трёхуровневую модель зрелости данных, где качество метаданных и семантического слоя напрямую определяет точность LLM, text-to-SQL и ИИ-агентов.
Midjourney в 2026 году: почему сильный визуальный стиль не делает его универсальным
Разбор Midjourney показывает, что в 2026 году его главный плюс — не универсальность, а узнаваемый стиль и глубокий контроль, который раскрывается только при осмысленной работе с промптами.
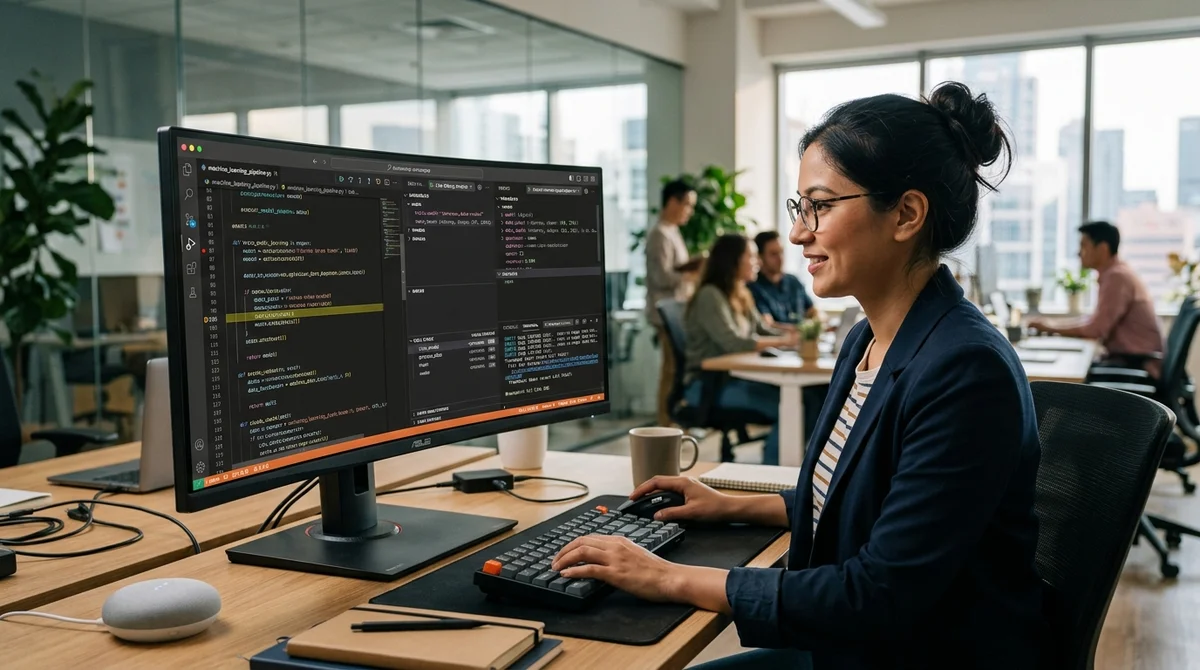
Cursor и Microsoft Research проверяют, нужен ли ИИ-агенту полноценный доступ к дебаггеру
Эксперимент с Debug2Fix и режимом Cursor Debug Mode показывает, что брейкпоинты, пошаговое выполнение и evaluate expression могут помочь ИИ-агенту заметно чаще чинить реальные баги.
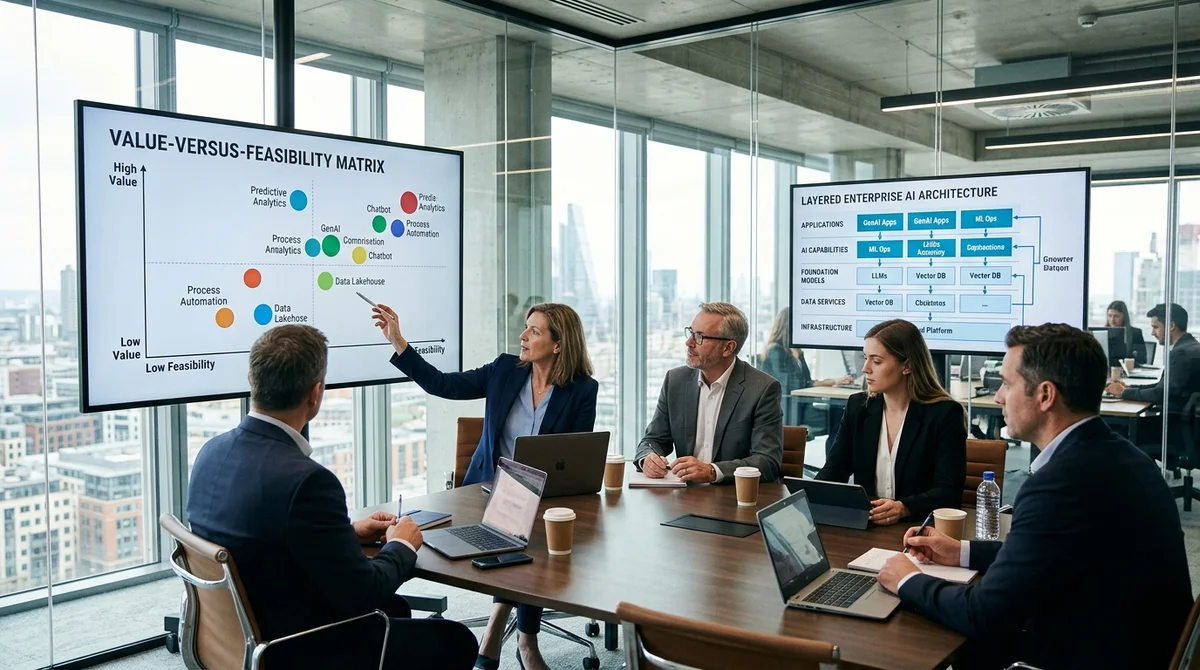
Raft показала, как приоритизировать AI-инициативы и собрать реалистичную дорожную карту
Raft разобрала, как оценивать ценность AI-инициатив, отсеивать слабые идеи через матрицу достижимости и собирать поэтапную дорожную карту трансформации.
Gemma 4 в Codex CLI: локальный запуск оказался рабочим, но пока слабее облака
Тест локальной Gemma 4 в Codex CLI показал, что модель уже умеет работать с tool calling и проходить тесты, но по качеству, стабильности и времени всё ещё уступает облачному GPT-5.4.
Почему LLM создают иллюзию творчества и не гарантируют настоящую новизну идей
LLM помогают быстро развивать замысел и доводить его до финальной формы, но их уверенный стиль легко маскирует вторичность, компиляцию и отсутствие реальной новизны.
Как ИИ-агенты и IBM меняют управление IT-проектами и роль менеджера проекта
ИИ-агенты выходят за пределы чат-ботов: они уже помогают менеджерам проектов планировать спринты, оценивать риски и разбирать инциденты, а кейс IBM показывает заметный эффект.
StudyAI: как генеративный ИИ подрывает доверие к текстам, голосам и видео в онлайне
StudyAI разбирает, как генеративный ИИ делает фейки убедительнее, обесценивает цифровые доказательства и толкает интернет к эпохе тотального недоверия.
Habr AI объяснил, почему LLM не считают, не учатся в диалоге и зависят от инструментов
Habr AI объясняет, что языковые модели сами по себе умеют только работать с текстом, а память, расчеты, поиск, агенты и «цифровые сотрудники» появляются за счет внешних инструментов.
Svoi.ru сократила подготовку к тестированию на 70% с помощью AI-агентов
Команда Svoi.ru показала, как AI-агенты могут автоматизировать разбор требований и подготовку тестовой документации, сняв с QA рутинную аналитику и сократив этот этап на 70%.
Kodik объяснила, почему публичные бенчмарки языковых моделей вводят в заблуждение
Kodik разобрала слабые места популярных тестов для LLM и показала, почему для AI-редактора кода важнее собственный бенчмарк, а не красивые проценты в чужих таблицах.
Как Google DeepMind и конкуренты меняют музыку: пять ИИ-сервисов для генерации треков
Подборка из пяти ИИ-сервисов показывает, как генерация музыки по текстовому запросу перестала быть игрушкой и стала рабочим инструментом для авторов, брендов и независимых продюсеров.
WisprFlow, Whisper и GigaAM: кто лучше распознаёт русско-английскую речь
Автор сравнил пять приложений и пять моделей голосового ввода для русско-английской смеси и показал, чем локальные open source-решения уже могут заменить WisprFlow.
GPTunneL и тренд Forbes: почему AI-супераппы становятся новой точкой роста рынка
GPTunneL, выросший до 2 млн пользователей, описывает, как AI-супераппы меняют поведение аудитории, спрос корпораций и экономику рынка — от Китая и США до России.
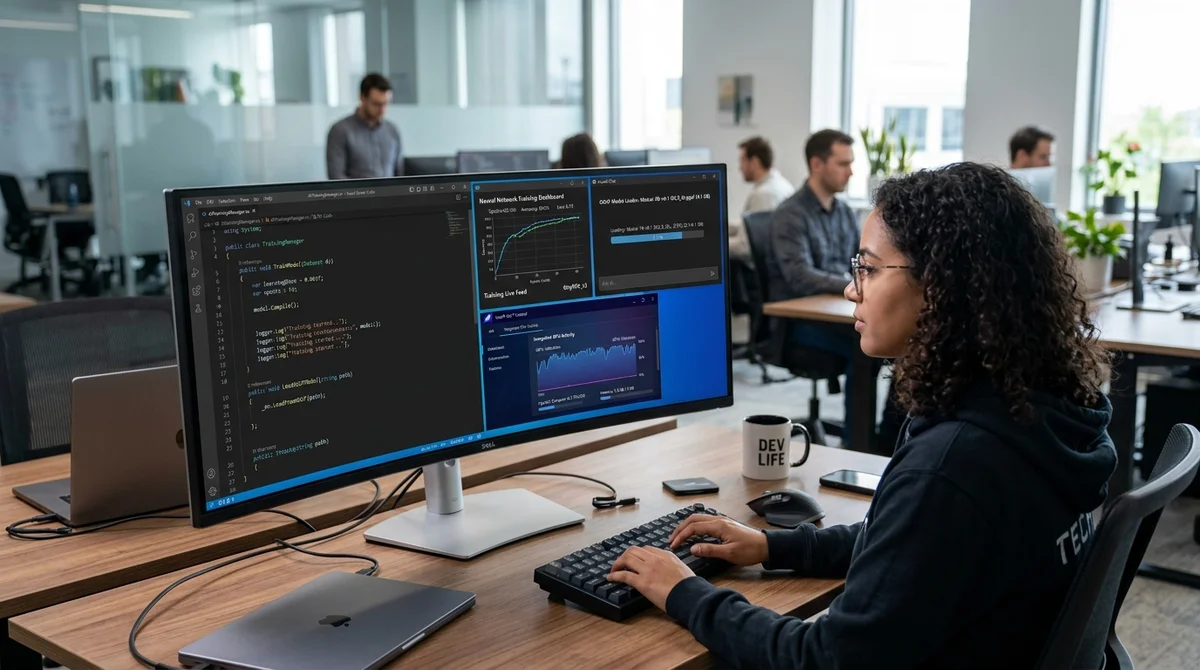
На Habr показали, как обучить мини-LLM на C# через ILGPU и встроенную AMD-графику
На Habr вышел разбор, как собрать и обучить крошечную LLM на C# с ILGPU и OpenCL, экспортировать её в GGUF и запустить в LM Studio даже на встроенной AMD-графике.
Anthropic показала Claude Mythos Preview через system card на 244 страницы вместо релиза
Anthropic представила Claude Mythos Preview не как обычный запуск, а через 244-страничную system card, где описаны возможности модели, риски и причины ограниченного доступа.