Локальные LLM
Локальные LLM — это языковые модели, которые работают прямо на вашем железе: ноутбуке, ПК с видеокартой или домашнем сервере — без облака, подписок и передачи данных наружу. Ollama, llama.cpp и LM Studio плюс квантованные GGUF-версии Llama, Qwen и Gemma делают это доступным даже на видеокарте десятилетней давности. Здесь — все наши материалы о локальном запуске ИИ: гайды, тесты железа, квантизация и приватность.


Разработчик построил локальный спам-фильтр на модели ruBert-base-antispam без VPN
Автор на Habr собрал многоуровневый фильтр спама: после Яндекса, Mail и SpamAssassin письма проверяет локальная BERT-модель на 177 миллионов параметров.

Python в ИИ: почему язык в 70 раз медленнее C и теряет позиции на edge
ИИ-индустрия в основном работает на Python, который в 70 раз медленнее C и занимает 26-е место из 27 по энергоэффективности среди языков программирования.

Как контекстная инженерия делает слабую локальную LLM надёжным агентом
Автор на Habr показал: для локальной LLM на закрытом контуре качество агента определяет не размер модели, а то, как устроен её контекст.


Syntiant подаёт на IPO: edge AI на чипах вырастает из лабораторий в биржу

OpenAI представила GPT-Live — обновлённый голосовой ChatGPT с поддержкой GPT-5.5

MiniMax привлекает $2 млрд на развитие AI-моделей через размещение акций

Google требует маркировки AI-реклам, Samsung готовит GAIA, Alibaba показала LingBot-VA 2.0

Ollama привлекла $65 млн и почти достигла 9 млн пользователей инструмента для ИИ
Open-source-инструмент Ollama для локального запуска ИИ привлёк $65 млн и почти достиг 9 млн пользователей, закрепив популярность среди разработчиков.

Hugging Face: transformers-бэкенд в vLLM теперь работает с нативной скоростью
Hugging Face объявила о паритете производительности: флаг --model-impl transformers даёт нативную скорость vLLM на 450+ архитектурах без переписывания кода.
Microsoft запустила Foundry Managed Compute: тысячи моделей Hugging Face одним кликом
Нейросеть для документов: Gemma 4 парсит PDF без OCR
ИИ для оценки интерфейсов: метод FlowEval от Apple
Broadcom продлила партнёрство с Apple по поставке кастомных чипов до 2031 года
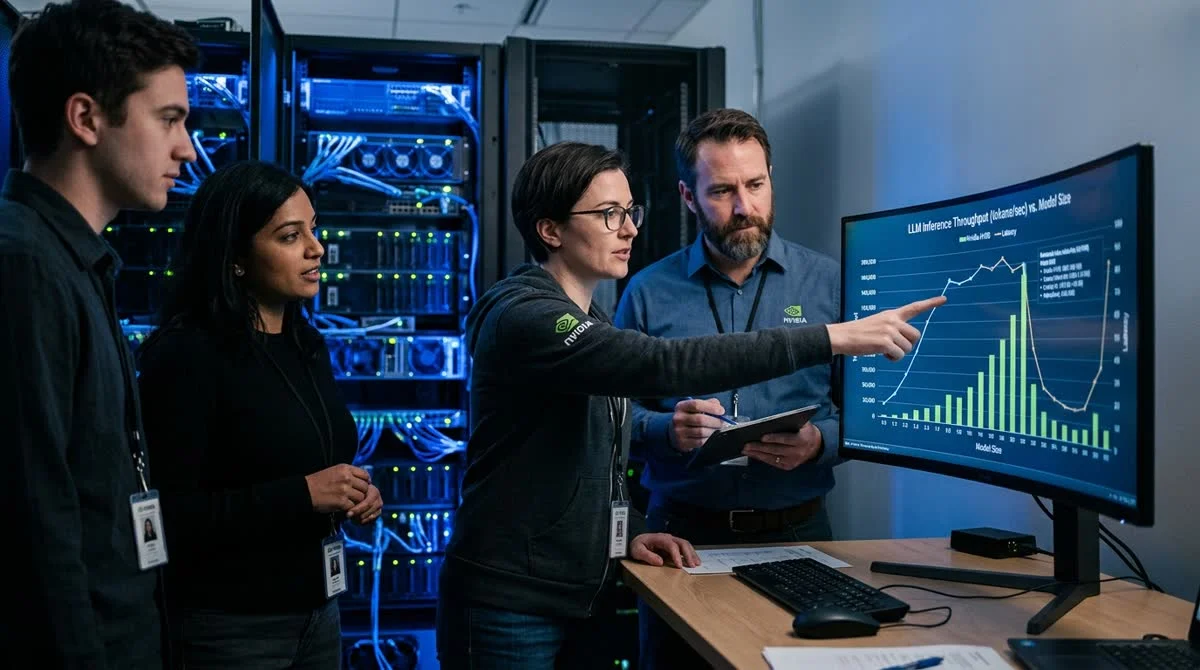
NVIDIA TensorRT теперь масштабирует инференс генеративного AI на несколько GPU
NVIDIA добавила в TensorRT нативную поддержку нескольких GPU — модели для генерации медиаконтента масштабируются в продакшне без потери ключевых оптимизаций движка.
7 лучших coding-моделей для локального запуска в 2026 году: Qwen, DeepSeek и другие
Обзор семи открытых AI-моделей для программирования, которые работают на вашем GPU в 2026 году — от лёгких 7B-вариантов до мощных 70B с агентными возможностями.